OpenAI GPT-Image-2:ComfyUI 推理式图像生成
在 ComfyUI 中使用 OpenAI GPT-Image-2 进行推理式图像生成:擅长密集文字与界面元素、2K 图像编辑,并可一次生成最多 8 张一致的图像。
OpenAI GPT-Image-2:ComfyUI 推理式图像生成
在 ComfyUI 中使用 OpenAI GPT-Image-2 进行推理式图像生成:擅长密集文字与界面元素、2K 图像编辑,并可一次生成最多 8 张一致的图像。
OpenAI GPT-Image-2 (gpt-image-2) 是 OpenAI 最新的图像模型,现可通过合作节点 (Partner Nodes) 在 ComfyUI 中使用。它是 OpenAI 第一款在生成前会进行推理的图像模型:它不是一次性采样,而是先规划画面构图、检查生成结果,并进行迭代。
此节点支持:
- 文生图,能够出色处理密集文字、UI 元素、图标、信息图、地图、幻灯片以及漫画分镜
- 图像编辑,在最高 2K 分辨率下保持高结构保真度
- 单个提示词最多可生成 8 张一致的图像,并保持角色和物体的连续性
在节点库的 OpenAI GPT Image 2.5 节点上,可将 GPT-Image-2 选为 model 选项。该节点会同步调用 OpenAI 的图像生成 API,并返回与描述匹配的图像。
GPT-Image-2 擅长什么
推理驱动的生成
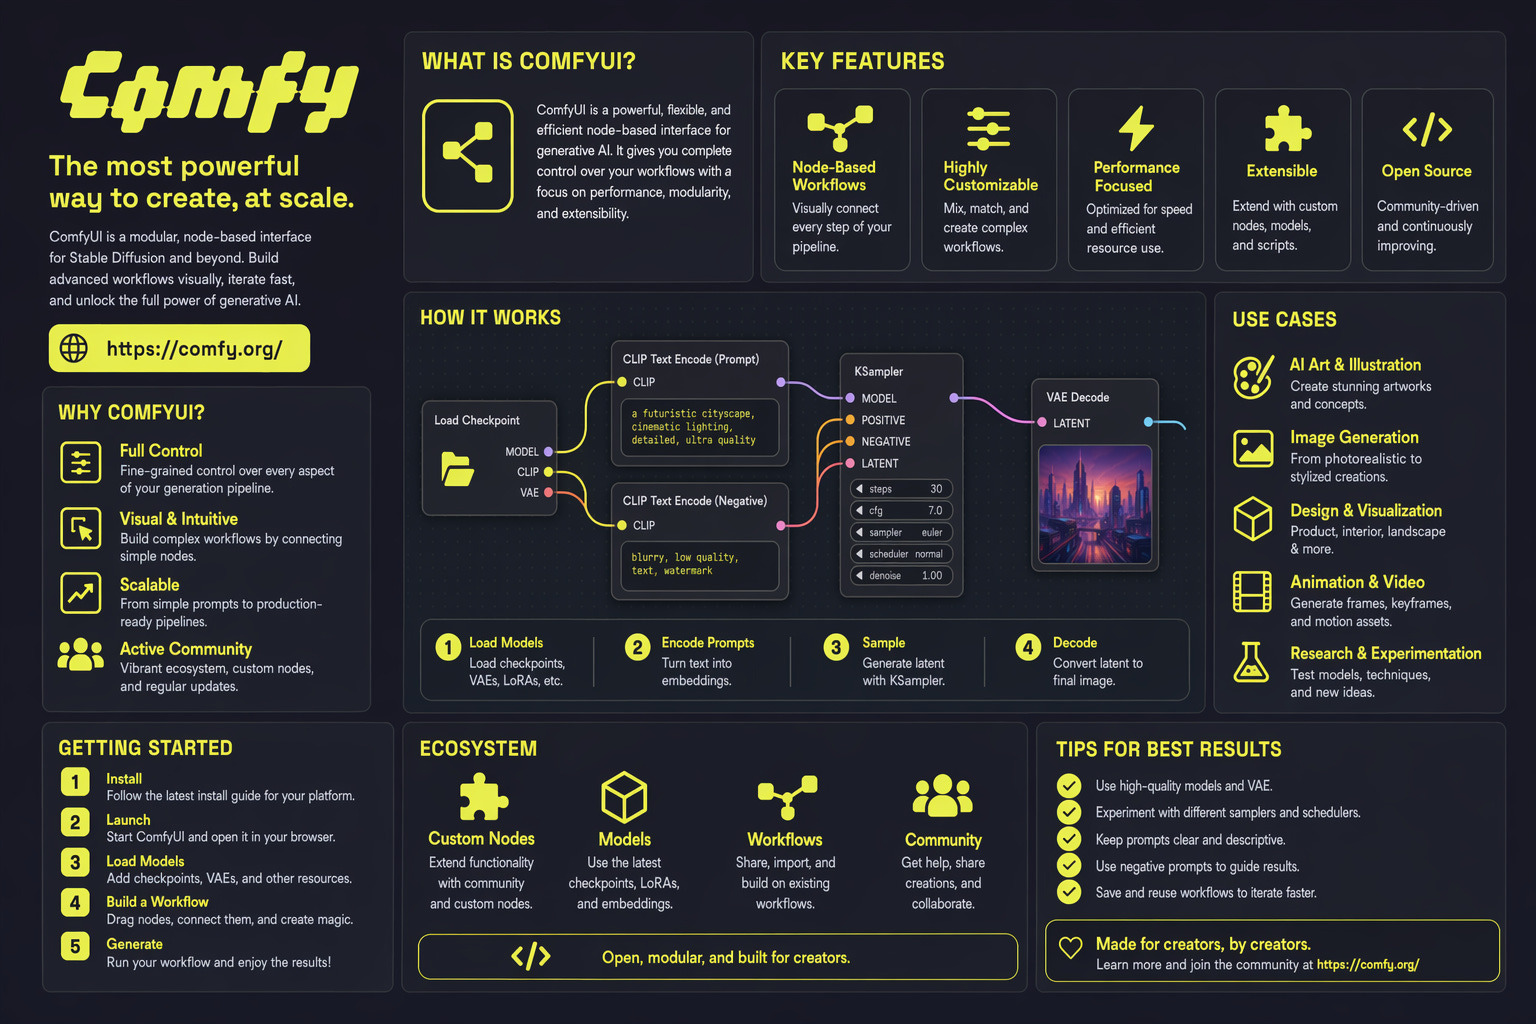
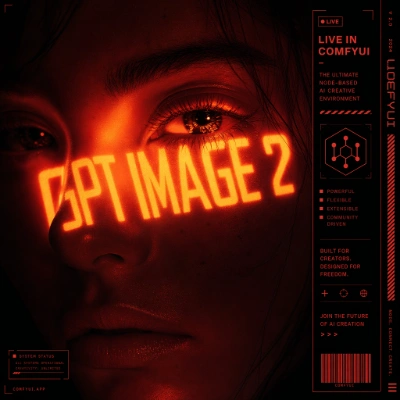
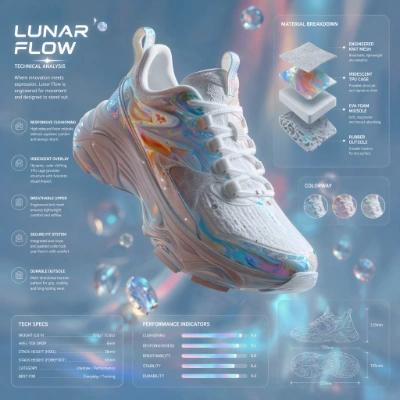
GPT-Image-2 会在渲染之前规划构图。这使得它非常适合处理那些历来会难倒图像模型的提示词:例如,要求生成一张海报,上面有一份包含七条项目的项目符号列表,使用 11pt Helvetica 字体并居中。它还能为密集文本、小型 UI 元素、图标、信息图、地图和幻灯片生成干净清晰的输出。
保留重要内容的图像编辑
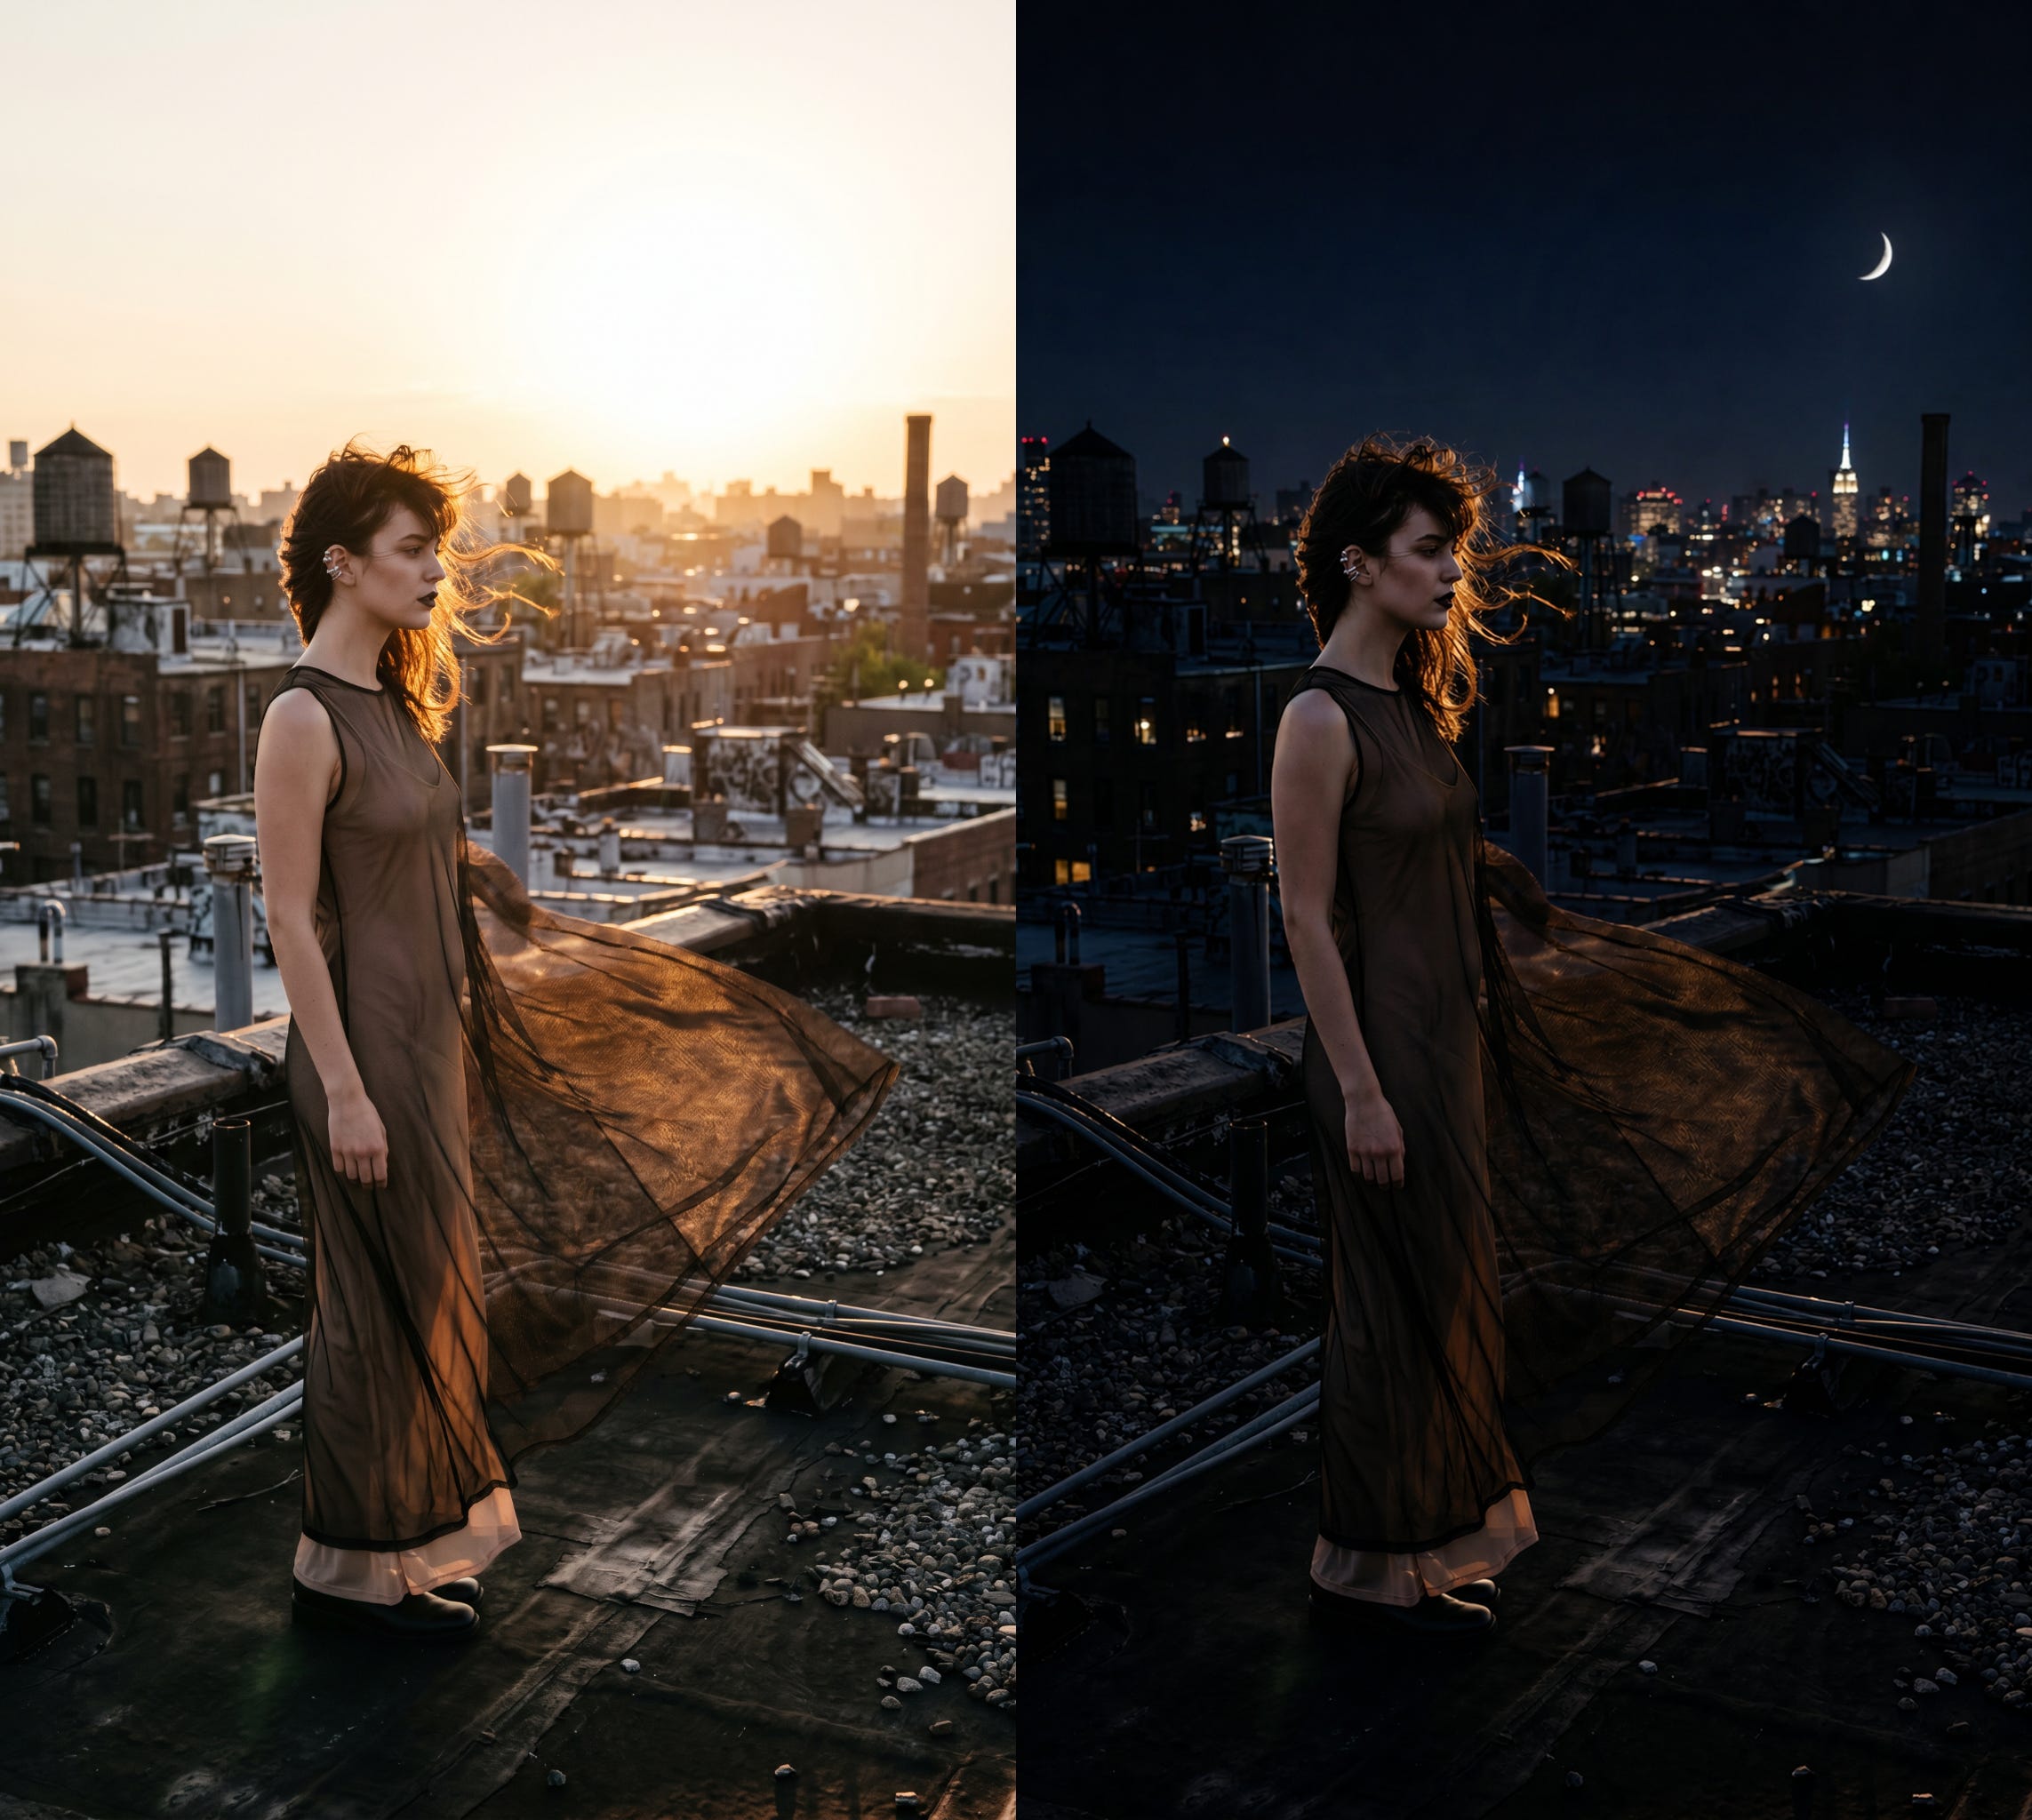
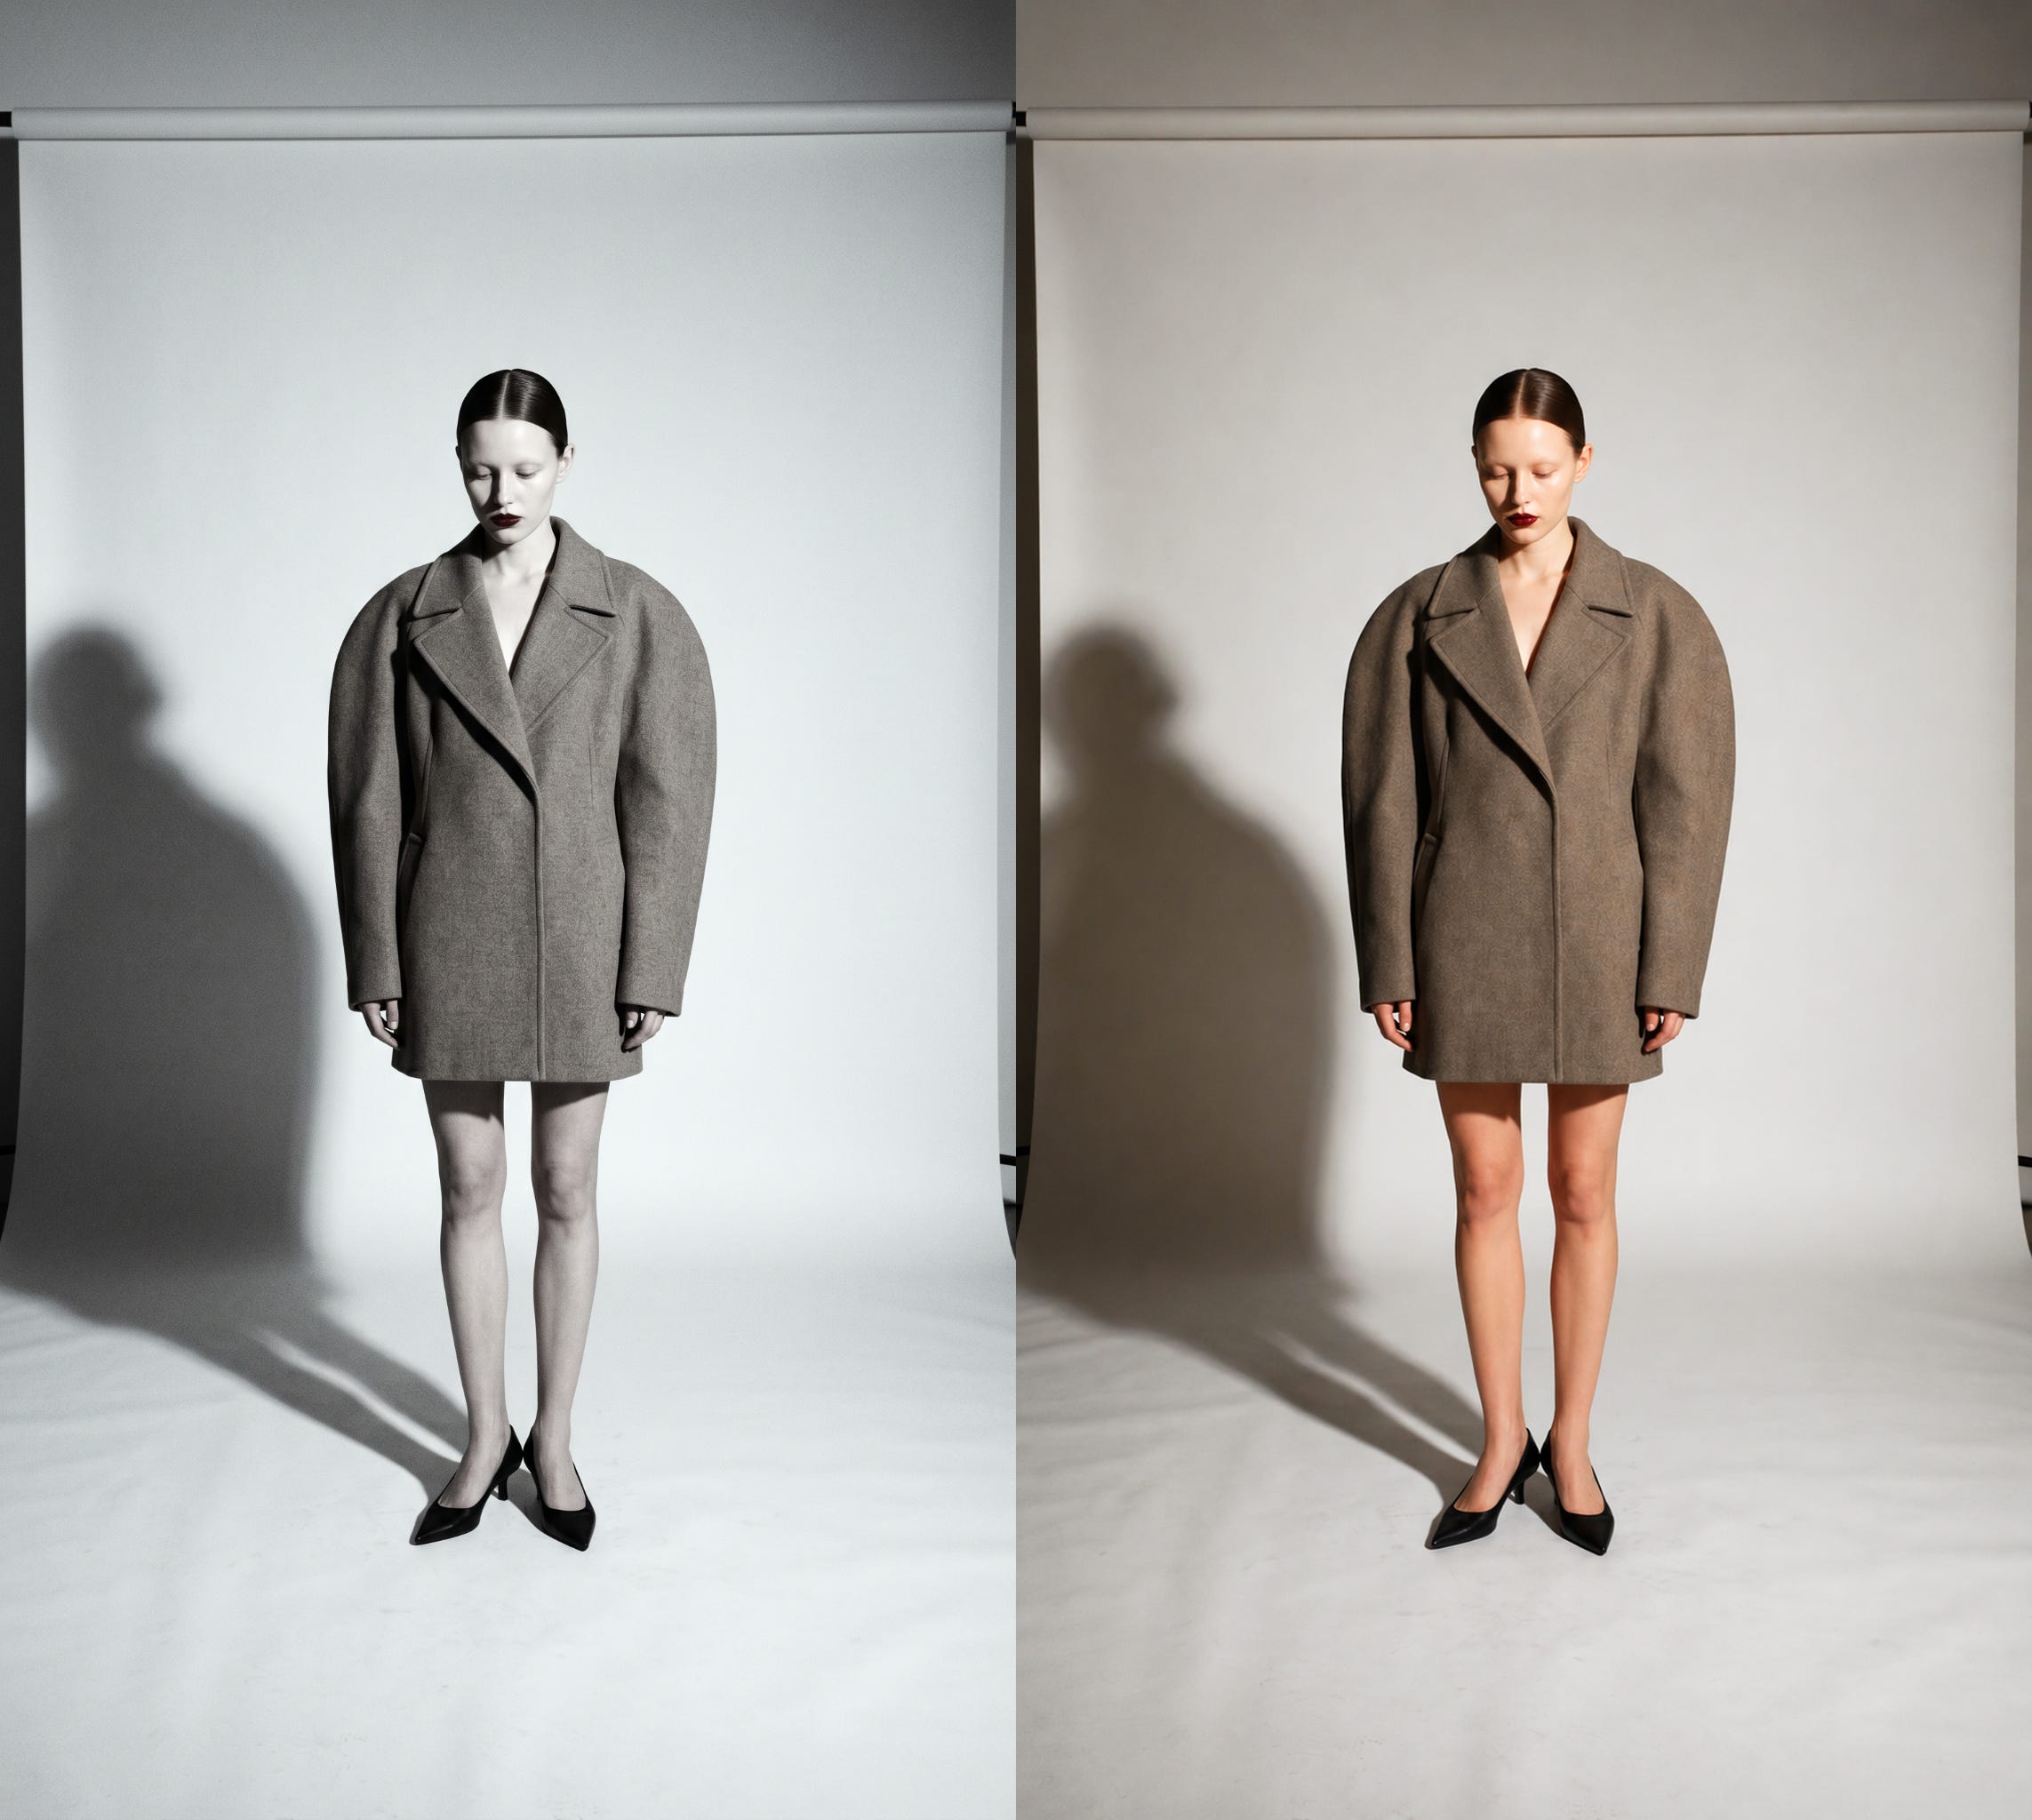
GPT-Image-2 能以结构保真度完成定向编辑,在保持编辑区域之外的一切像素稳定的同时,干净地应用所请求的修改,最高分辨率可达 2K。可将它用于为黑白照片上色,或将场景从正午变为黄昏等使用例,全程不会扭曲面部、几何结构或精细细节。
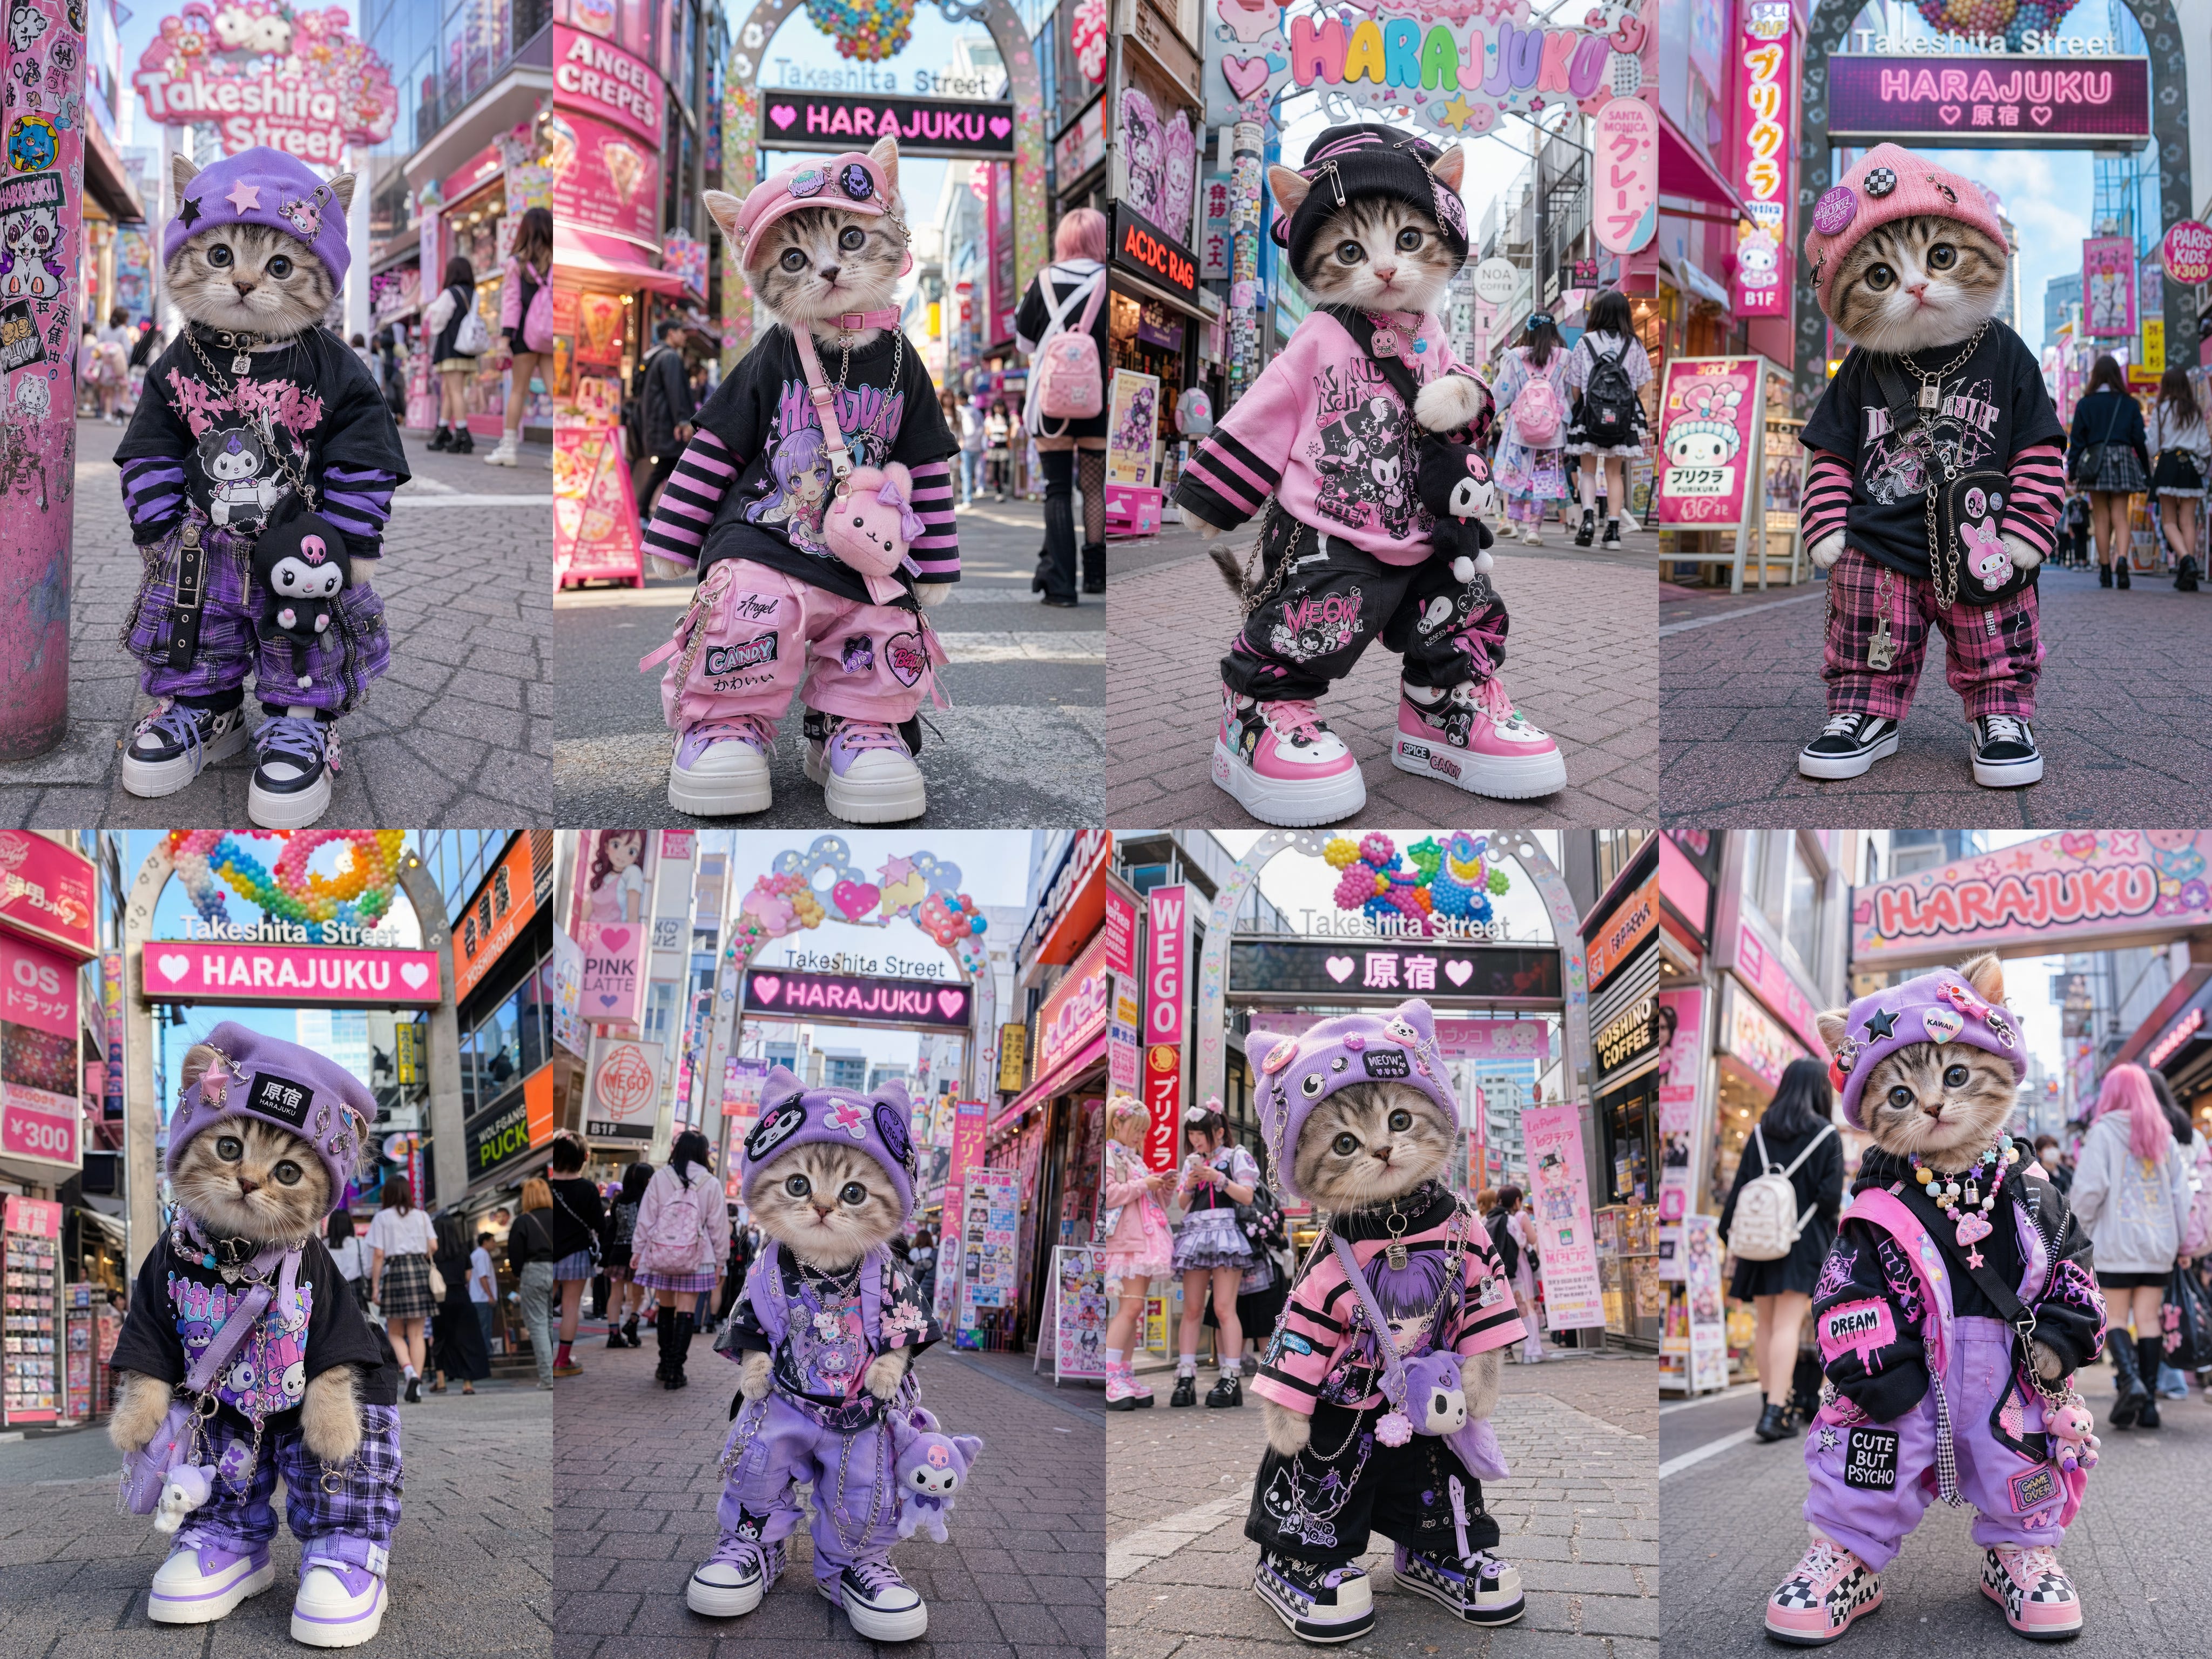
每个提示词最多生成八张一致的图像
该模型从单个提示词中最多可返回八张不同的图像,同时在整个系列中保持角色和物体的连续性。这使得它非常适合制作故事板、参考图、角色转面图和产品变体,无需锁定种子或费心雕琢提示词。将这一批图像直接送入 Save Image 节点,或在其后接入视频工作流即可。
混合 Pipeline
GPT-Image-2 可以自然嵌入到混合 Pipeline 中:用它生成包含大量文字的关键画面,然后交给本地模型进行图像放大、风格化或视频生成:在同一个工作流中,每个步骤都用最合适的模型。
示例输出
基于推理驱动的构图进行文生图生成:
在输入图像上进行图像编辑,同时保留编辑区域之外的图像结构:
[!TIP] 使用 API 节点需要保证你已经正常登录,并在受许可的网络环境下使用,请参考API 节点总览部分文档来了解使用 API 节点的具体使用要求。
[!TIP] > [tab] 本地用户 > > 请确保你的 ComfyUI 已经更新。 > > ComfyUI 下载 > ComfyUI 更新教程 > > 本指南里的工作流可以在工作流模板中找到。如果找不到,可能是 ComfyUI 没有更新。 > > 如果加载工作流时有节点缺失,可能原因有: > > 1. 你用的不是最新版(每夜版)。 > 2. 启动时有些节点导入失败。 > [tab] 云端用户 > > * Cloud 会在 ComfyUI 稳定版本发布后更新。 > > 所以,如果你发现本文档中有任何核心节点缺失,可能是因为新核心节点尚未在最新稳定版中发布。请等待下一个稳定版发布。
快速开始
- 将 ComfyUI 更新到最新版本(v0.19.4 或更高),或使用 Comfy Cloud。
- 在节点库中搜索 OpenAI GPT Image 2.5 并添加节点。
- 将
model字段设置为gpt-image-2。
可用工作流
文生图 (T2I)
通过文本提示词生成图像,利用 GPT-Image-2 基于推理的构图能力。
[card] 在 Comfy Cloud 运行文生图 在 Comfy Cloud 上一键体验文生图工作流。
[card] 下载文生图工作流 下载工作流 JSON 文件。
图像编辑
对输入图像进行编辑,在最高 2K 分辨率下保持结构一致性。
[card] 在 Comfy Cloud 运行图像编辑 在 Comfy Cloud 上一键体验图像编辑工作流。
[card] 下载图像编辑工作流 下载工作流 JSON 文件。
[card] 下载示例输入图像 获取此工作流的示例输入图像