
SDPose:ComfyUI 中的姿态检测
学习如何使用 ComfyUI 原生支持的 SDPose 从图像和视频中提取姿态关键点和姿态图
SDPose:ComfyUI 中的姿态检测
学习如何使用 ComfyUI 原生支持的 SDPose 从图像和视频中提取姿态关键点和姿态图
[!TIP] > [tab] 本地用户 > > 请确保你的 ComfyUI 已经更新。 > > ComfyUI 下载 > ComfyUI 更新教程 > > 本指南里的工作流可以在工作流模板中找到。如果找不到,可能是 ComfyUI 没有更新。 > > 如果加载工作流时有节点缺失,可能原因有: > > 1. 你用的不是最新版(每夜版)。 > 2. 启动时有些节点导入失败。 > [tab] 云端用户 > > * Cloud 会在 ComfyUI 稳定版本发布后更新。 > > 所以,如果你发现本文档中有任何核心节点缺失,可能是因为新核心节点尚未在最新稳定版中发布。请等待下一个稳定版发布。
SDPose 是一种全身姿态检测模型,可从图像和视频中提取人体关键点。结合 RT-DETRv4 对象检测器,它支持多人检测和跨域(OOD)姿态估计,使其成为动画管线、姿态驱动生成和运动追踪工作流中的多功能工具。
SDPose + RT-DETRv4 已在 ComfyUI 中原生支持(PR #12748)。模型权重可在 Hugging Face 上获取。
Hugging Face 上的 SDPose 模型 | RT-DETRv4 论文 (arXiv) | SDPose 论文 (arXiv)
主要优势
- 全身关键点 — 在统一的模型中检测身体、手部、面部和脚部关键点
- 多人支持 — 在单张图像或视频中检测并标注多人
- 可配置的输出 — 可选择可视化哪些身体部位(身体、手部、面部、脚部),并控制骨架线宽和字体大小
- 边界框检测 — 包含对象检测,可调节阈值和类别选择
- 图像和视频支持 — 针对单张图像、视频和 OOD 姿态估计提供专门的工作流
局限性: 检测精度取决于图像分辨率和目标可见性。极度遮挡或非常小的目标可能产生较少的关键点。
SDPose 工作流
根据您的用例,有四种工作流可供选择:
| 工作流 | 输入 | 输出 | 用例 |
|---|---|---|---|
| Multi-Person (Image) | 单个图像 | 姿态图 + 边界框 | 包含多人的照片 |
| Multi-Person (Video) | 视频 | 逐帧姿态图 + 边界框 | 视频姿态跟踪 |
| OOD Image to Pose | 单个图像 | 姿态图 | 风格迁移 / 图像转姿态 |
| OOD Video to Pose Map | 视频 | 逐帧姿态图 | 视频转姿态动画 |
1. 下载工作流
将您的 ComfyUI 更新到最新版本,然后转到 Workflow -> Browse Templates,在“Utility”类别下找到 SDPose 工作流。
SDPose:图像多人检测
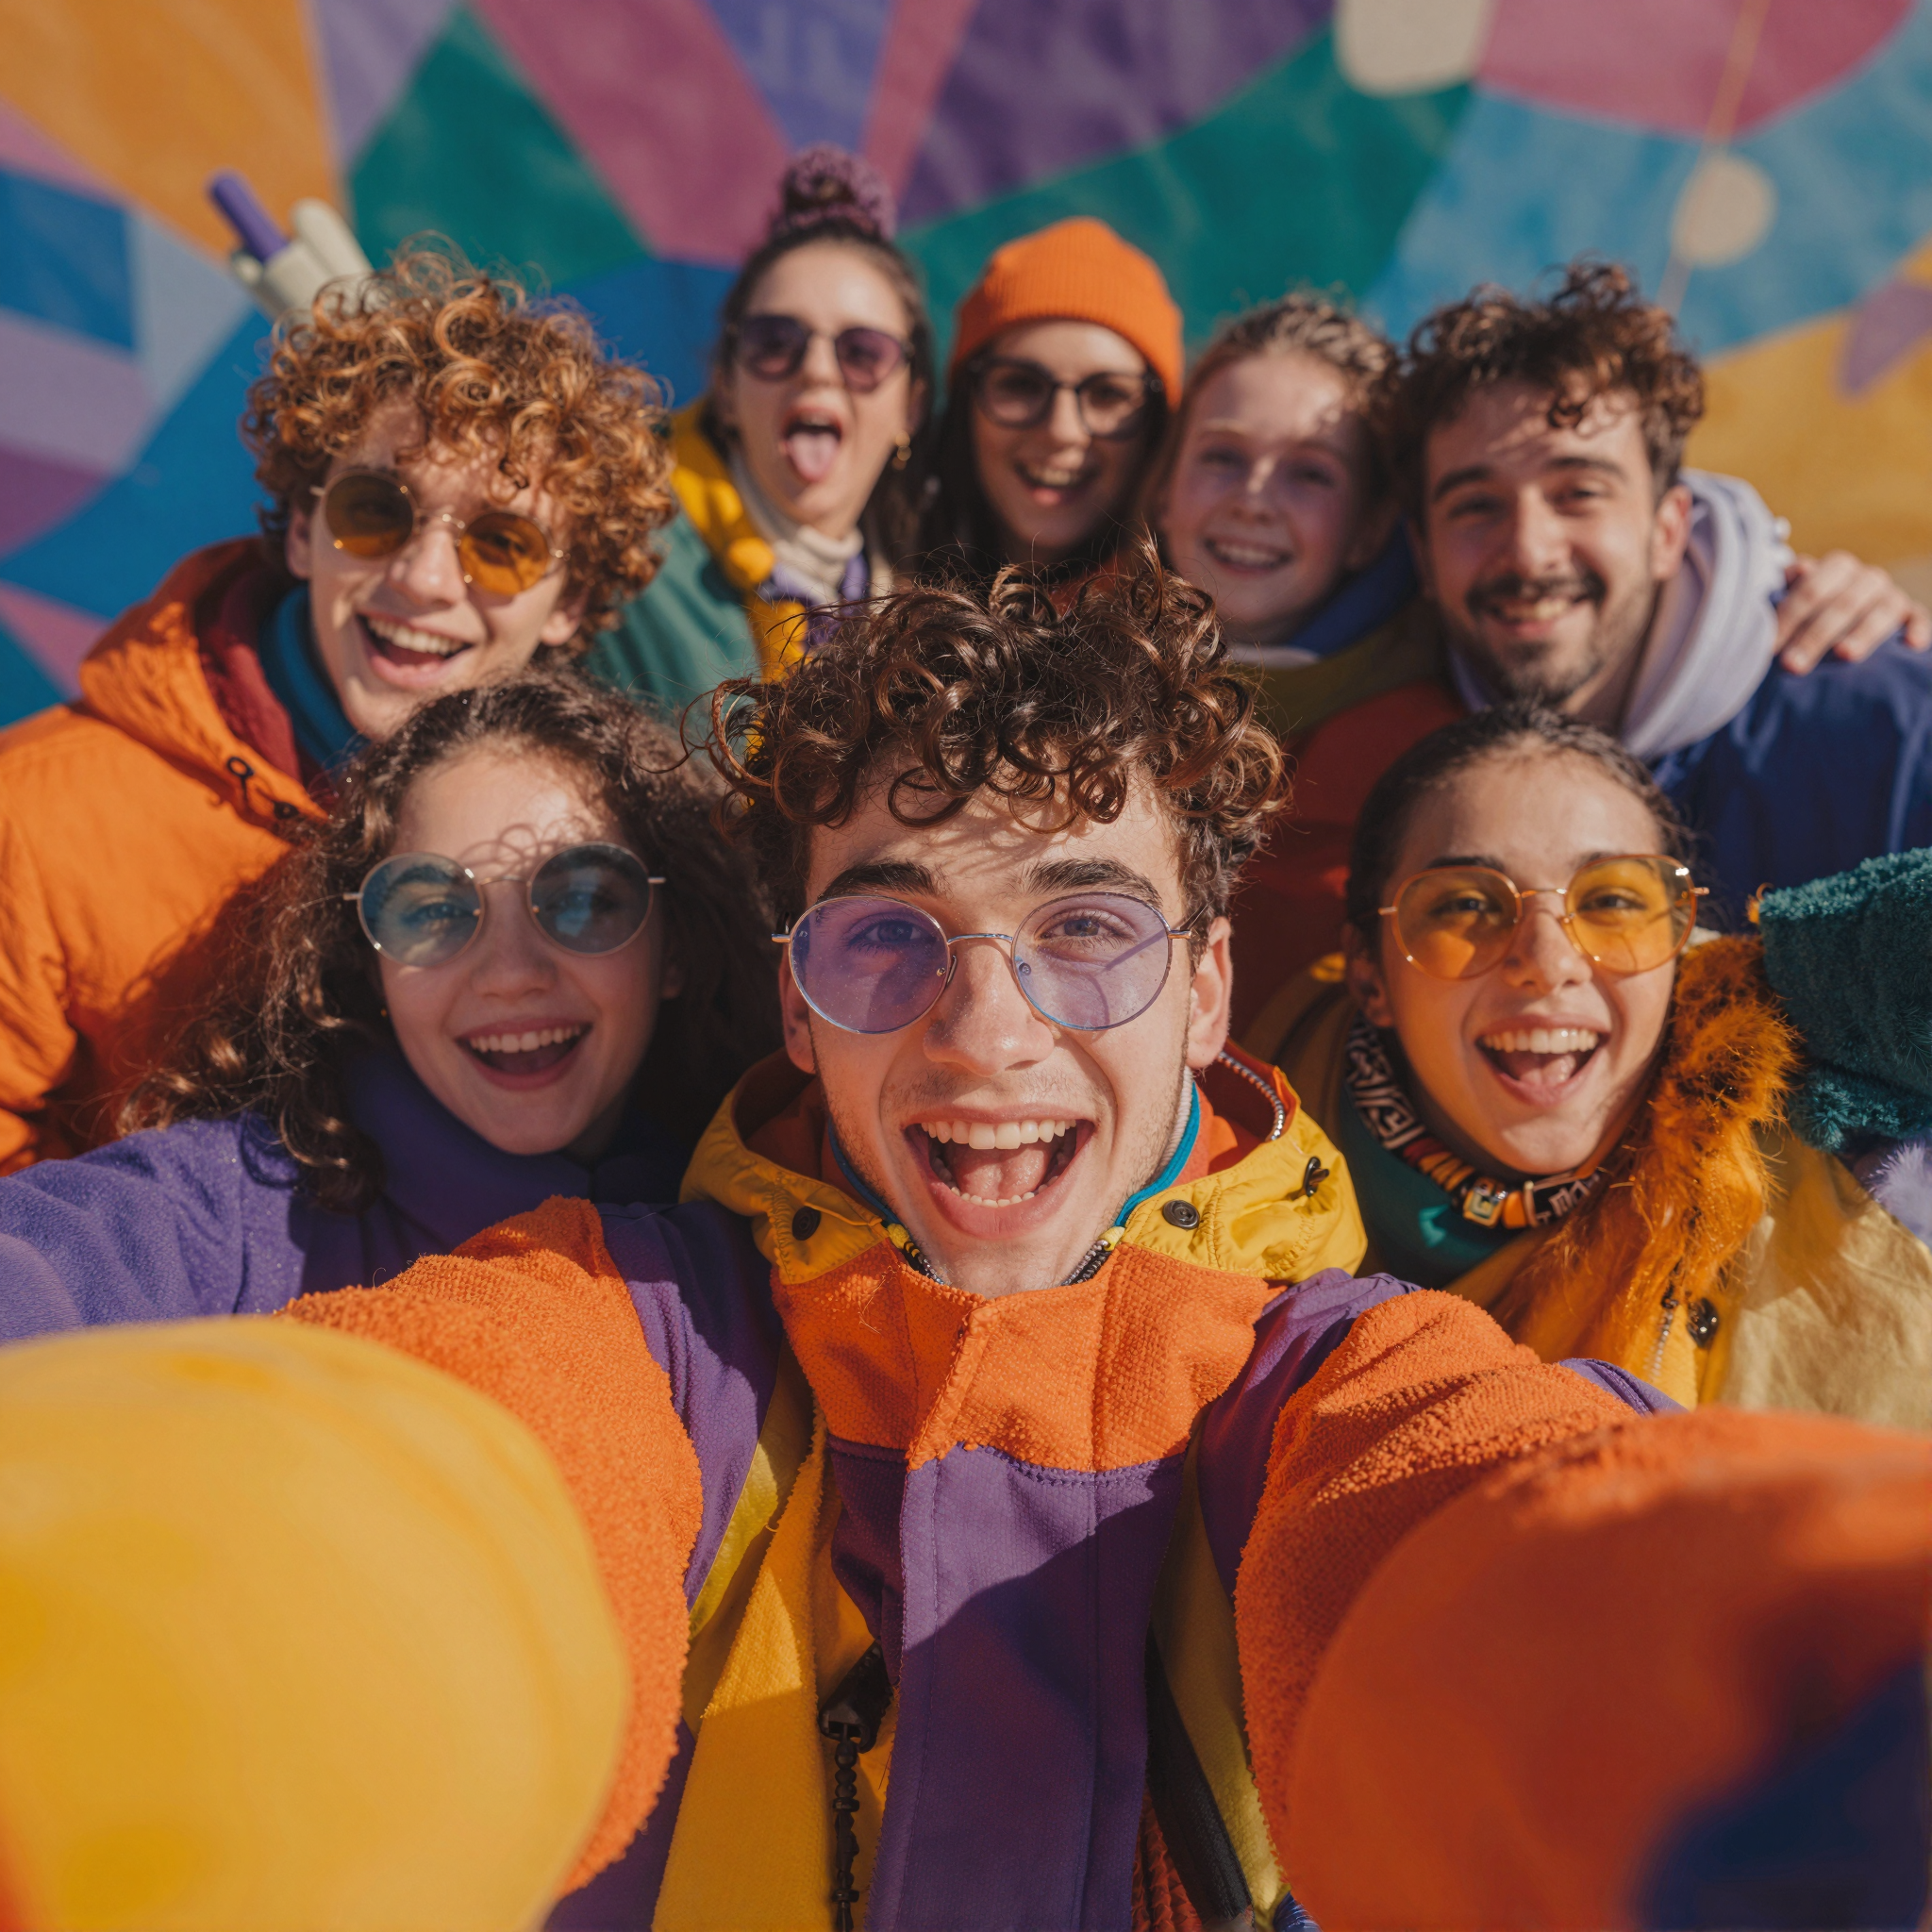
上传图片以检测人体姿态。支持检测同一场景中的单人和多人。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索 "SDPose:图像多人检测"
输入素材
将此文件上传到匹配的 LoadImage 节点:
[card] group\_photo.pngLoadImage节点 679 ·group_photo.png
SDPose:视频多人检测
上传视频以检测人体姿态。支持在同一场景中检测单人和多人。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索 "SDPose:视频多人检测"
输入素材
将以下文件上传到对应的 LoadVideo 节点:
[card] man\_playing\_violin.mp4LoadVideo节点 694 ·man_playing_violin.mp4
<video controls> <source src="https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/input/man_playing_violin.mp4" type="video/mp4" /> </video>
SDPose-OOD:图像到姿态图
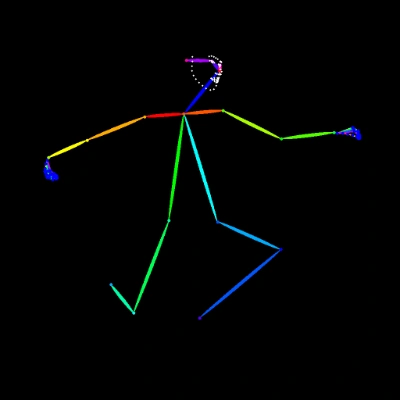
上传图片以提取姿态关键点,并使用 SDPose-OOD 模型生成对应的姿态图。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索“SDPose-OOD:图像到姿态图”
输入材料
将以下文件上传到对应的 LoadImage 节点:
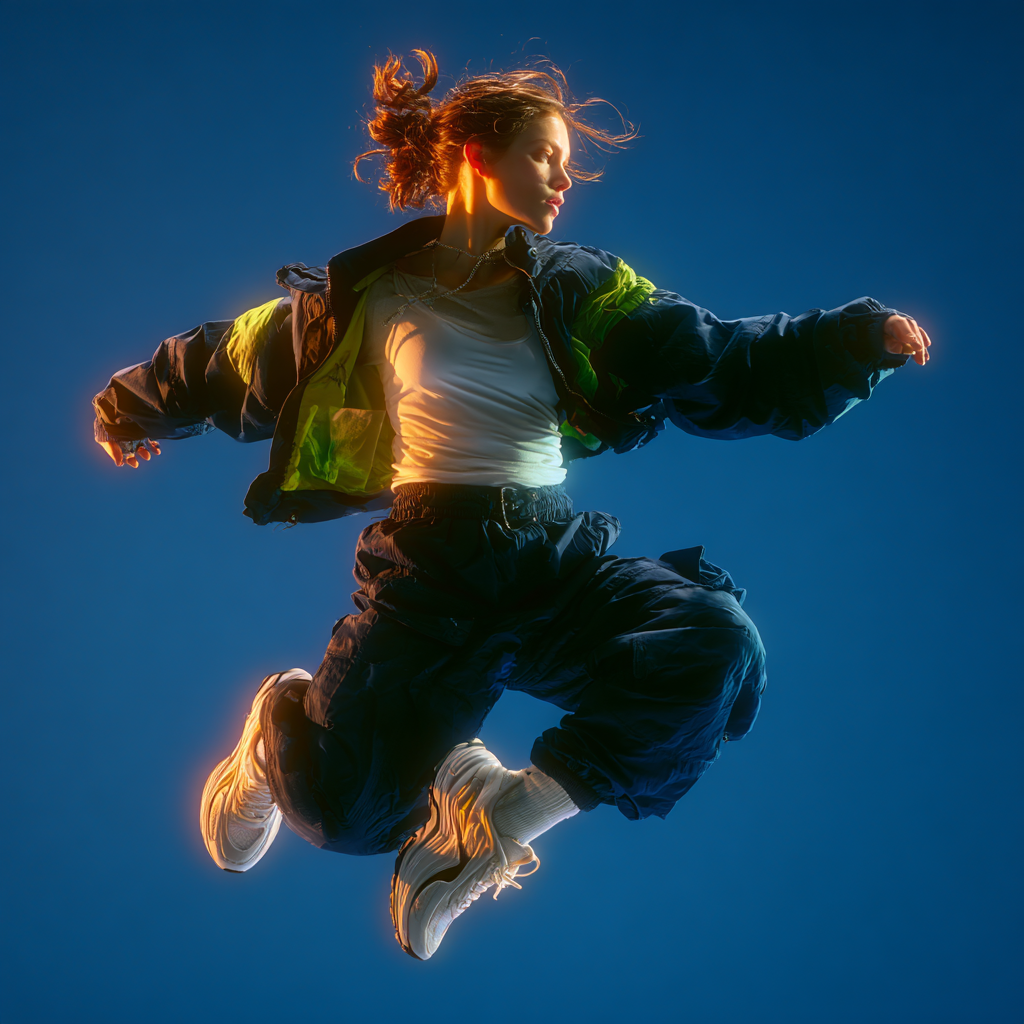
[card] dancer.pngLoadImage节点 667 ·dancer.png
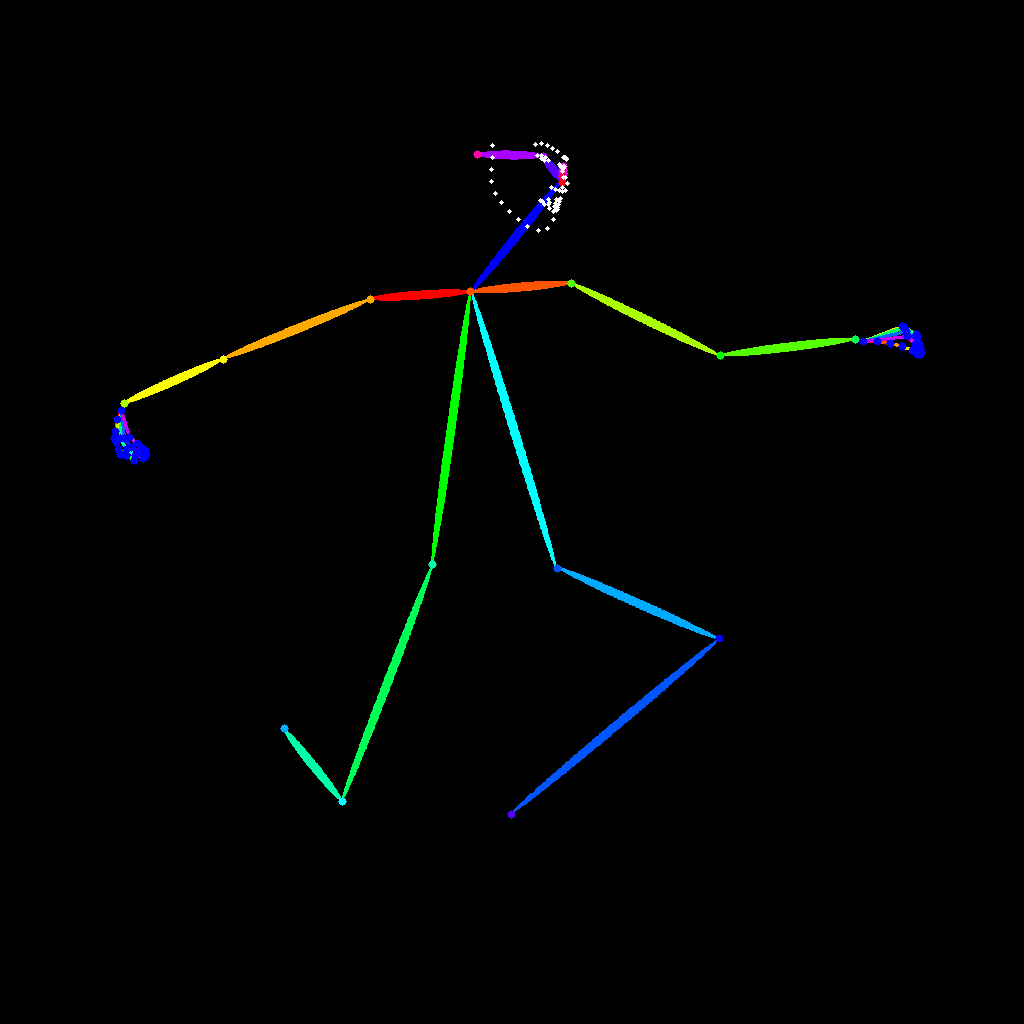
示例输出
SDPose-OOD:视频到姿态图
上传视频以提取姿态关键点并生成姿态图。该工作流支持多人检测,并使用增强型 SDPose 模型进行精准的全身特征提取。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索“SDPose-OOD:视频到姿态图”
输入材料
将此文件上传到对应的 LoadVideo 节点:
[card] man\_in\_the\_rain.mp4LoadVideo节点 679 ·man_in_the_rain.mp4
示例输出
<video controls> <source src="https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/input/man_in_the_rain.mp4" type="video/mp4" /> </video>
<video controls> <source src="https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/output/utility_sdpose_ood_video_to_pose_map.mp4" type="video/mp4" /> </video>
2. 下载模型
SDPose 和 RT-DETRv4 模型托管在 Comfy-Org SDPose 模型仓库 中。
checkpoints(SDPose 模型):
diffusion\_models(RT-DETRv4 检测器):
将它们放入以下目录结构中:
📂 ComfyUI/
└── 📂 models/
    ├── 📂 checkpoints/
    │   └── sdpose_wholebody_fp16.safetensors
    └── 📂 diffusion_models/
        ├── rt_detr_v4-x-hgnet_fp16.safetensors
        └── rt_detr_v4-x-hgnet_fp32.safetensors
3. 使用工作流
多人(图像)
- 输入:通过
Load Image节点加载图像。使用包含一个或多个人的图像(例如:group_photo.png)。 - 检测:
Image to Pose Map (SDPose Multi-Person)子图处理图像并输出: - IMAGE:叠加在图像上的姿势骨骼可视化
- keypoints:原始全身关键点数据
- bboxes:边界框坐标
- 绘制选项:配置要绘制的身体部位:
draw_body、draw_hands、draw_face、draw_feet:切换可见性stick_width、face_point_size:调整视觉样式score_threshold:显示关键点的最低置信度- 检测选项:
resize_type.longer_size:在检测之前缩放较长边max_detections:最大检测人数detect_threshold:检测置信度阈值detect_class:要检测的目标类别(默认:person)
多人(视频)
与图像工作流相同,但会按顺序处理视频帧。使用 Load Video 输入视频文件,并使用 Save Video 导出结果。
OOD 图像转姿势
使用 SDPose 模型从图像生成干净的姿势图,不包含边界框可视化。这在风格迁移中非常有用,您可以从一张图像中提取骨骼姿势,并将其应用到另一张图像上。
OOD 视频转姿势图
从视频生成逐帧姿势图。输出是一个视频文件,其中每一帧都包含提取出的姿势骨骼,适用于下游动画或 ControlNet 工作流。
[card] 了解子图 这些工作流使用子图节点进行模块化处理。查看子图文档,了解如何自定义和扩展工作流。
附加说明
- 模型目录 — SDPose 模型文件放在
models/checkpoints/中,RT-DETRv4 检测器放在models/diffusion_models/中 - 输入图像示例 — 工作流模板的
input/目录中提供了group_photo.png文件以供测试 - 关键点输出 — POSE\_KEYPOINT 类型可以连接到接受姿态数据进行条件生成的下游节点
- 需要更新 — 较新的 ComfyUI 版本才支持 SDPose + RT-DETRv4。请确保你的 ComfyUI 是最新版本。