
文档 /
教程 /
Kandinsky 5.0:ComfyUI 文生视频与图生视频
Kandinsky 5.0:ComfyUI 文生视频与图生视频
在 ComfyUI 中使用 Kandinsky 5.0 Video Lite:文生视频最长 10 秒、图生视频为 5 秒,提供 2B 参数的 SFT、no-CFG 与蒸馏版本。
教程
kandinsky-5 更新于 2026-11-12
Kandinsky 5.0:ComfyUI 文生视频与图生视频
在 ComfyUI 中使用 Kandinsky 5.0 Video Lite:文生视频最长 10 秒、图生视频为 5 秒,提供 2B 参数的 SFT、no-CFG 与蒸馏版本。
Kandinsky 5.0 是由 Kandinsky Lab 开发的视频和图像生成扩散模型系列。Kandinsky 5.0 T2V Lite 是一个轻量级的 2B 参数模型,位居开源视频生成模型的前列,能够生成最长 10 秒的视频。
[!TIP] > [tab] 本地用户 > > 请确保你的 ComfyUI 已经更新。 > > ComfyUI 下载 > ComfyUI 更新教程 > > 本指南里的工作流可以在工作流模板中找到。如果找不到,可能是 ComfyUI 没有更新。 > > 如果加载工作流时有节点缺失,可能原因有: > > 1. 你用的不是最新版(每夜版)。 > 2. 启动时有些节点导入失败。 > [tab] 云端用户 > > * Cloud 会在 ComfyUI 稳定版本发布后更新。 > > 所以,如果你发现本文档中有任何核心节点缺失,可能是因为新核心节点尚未在最新稳定版中发布。请等待下一个稳定版发布。
概述
Kandinsky 5.0 使用带有 Flow Matching 的潜在扩散管线,具有以下特点:
- Diffusion Transformer (DiT): 主要的生成骨干网络,带有对文本嵌入的交叉注意力
- Qwen2.5-VL 和 CLIP: 提供高质量的文本嵌入
- HunyuanVideo 3D VAE: 将视频编码和解码到潜在空间
该模型系列包含针对不同用例优化的多个变体:
- SFT 模型: 最高的生成质量
- CFG-distilled: 推理速度提升 2 倍
- Diffusion-distilled: 速度提升 6 倍且质量损失最小(16 步)
- Pretrain 模型: 为微调而设计
所有模型均提供 5 秒和 10 秒视频生成版本。
模型变体
| 模型 | 视频时长 | NFE | 延迟 (H100) |
|---|---|---|---|
| Kandinsky 5.0 T2V Lite SFT | 5s / 10s | 100 | 139s / 224s |
| Kandinsky 5.0 T2V Lite no-CFG | 5s / 10s | 50 | 77s / 124s |
| Kandinsky 5.0 T2V Lite distill | 5s / 10s | 16 | 35s / 61s |
| Kandinsky 5.0 I2V Lite | 5s | 100 | 673s |
文生视频工作流
Kandinsky 5.0 Video Lite 文生视频
一个轻量级 2B 模型,可从英文和俄文提示词生成高视觉质量的视频。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON 或在模板库中搜索"Kandinsky 5.0 Video Lite Text to Video"
2. 手动下载模型
文本编码器
[card] Text Encoder: qwen\_2.5\_vl\_7b\_fp8\_scaled.safetensors Qwen2.5-VL 7B 文本编码器(FP8)。放入 ComfyUI/models/text_encoders/
[card] Text Encoder: clip\_l.safetensors CLIP-L 文本编码器。放入 ComfyUI/models/text_encoders/
Diffusion Model
[card] Diffusion Model: kandinsky5lite\_t2v\_sft\_5s.safetensors Kandinsky 5.0 T2V Lite SFT diffusion 模型(5s)。放入 ComfyUI/models/diffusion_models/
VAE
[card] VAE: hunyuan\_video\_vae\_bf16.safetensors HunyuanVideo 3D VAE。放入 ComfyUI/models/vae/
ComfyUI/
├── 📂 models/
│   ├── 📂 text_encoders/
│   │      ├── qwen_2.5_vl_7b_fp8_scaled.safetensors
│   │      └── clip_l.safetensors
│   ├── 📂 diffusion_models/
│   │      └── kandinsky5lite_t2v_sft_5s.safetensors
│   └── 📂 vae/
│          └── hunyuan_video_vae_bf16.safetensors
图生视频工作流
Kandinsky 5.0 Video Lite 图生视频
一个轻量级 2B 模型,可从英文和俄文提示词生成高视觉质量的视频。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON 或在模板库中搜索"Kandinsky 5.0 Video Lite Image to Video"
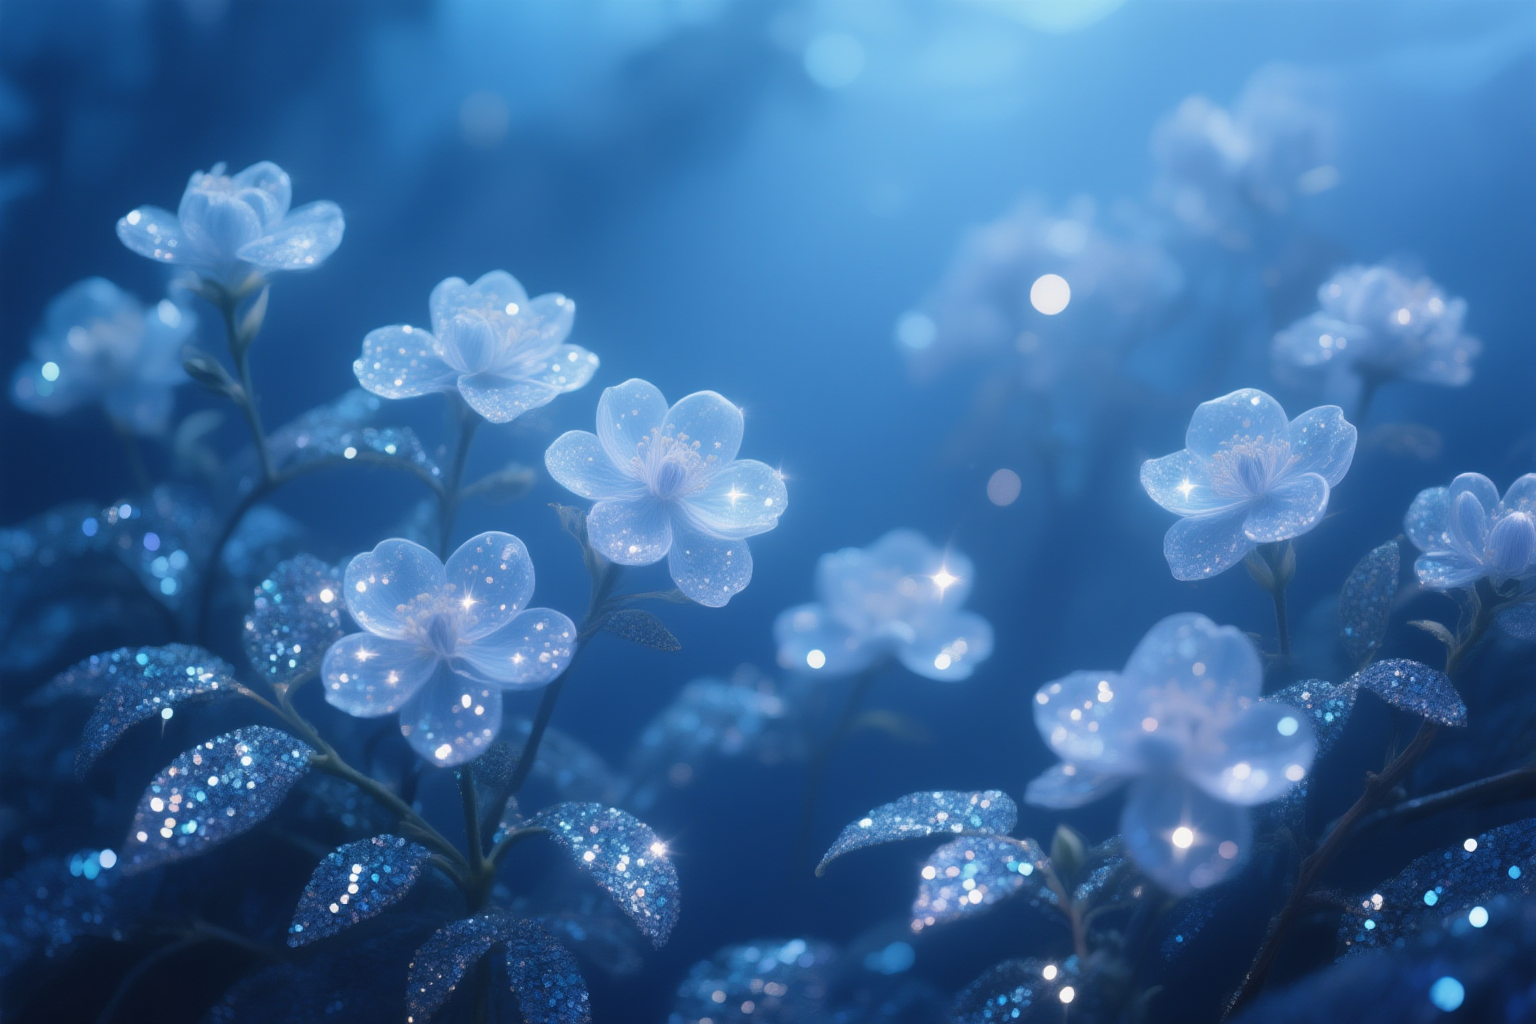
输入素材
将此文件上传到对应的 LoadImage 节点:
[card] crystal\_flower.pngLoadImage节点 11 ·crystal_flower.png
2. 手动下载模型
文本编码器
[card] Text Encoder: qwen\_2.5\_vl\_7b\_fp8\_scaled.safetensors Qwen2.5-VL 7B 文本编码器(FP8)。放入 ComfyUI/models/text_encoders/
[card] Text Encoder: clip\_l.safetensors CLIP-L 文本编码器。放入 ComfyUI/models/text_encoders/
Diffusion Model
[card] Diffusion Model: kandinsky5lite\_i2v\_5s.safetensors Kandinsky 5.0 I2V Lite diffusion 模型(5s)。放入 ComfyUI/models/diffusion_models/
VAE
[card] VAE: hunyuan\_video\_vae\_bf16.safetensors HunyuanVideo 3D VAE。放入 ComfyUI/models/vae/
ComfyUI/
├── 📂 models/
│   ├── 📂 text_encoders/
│   │      ├── qwen_2.5_vl_7b_fp8_scaled.safetensors
│   │      └── clip_l.safetensors
│   ├── 📂 diffusion_models/
│   │      └── kandinsky5lite_i2v_5s.safetensors
│   └── 📂 vae/
│          └── hunyuan_video_vae_bf16.safetensors