
文档 /
教程 /
Wan2.1:ComfyUI 文生视频与图生视频工作流
Wan2.1:ComfyUI 文生视频与图生视频工作流
运行 1.3B 文生视频模型与 14B 图生视频模型,包含模型文件安装和两者的原生 ComfyUI 工作流。
教程
wan-video 更新于 2026-10-19
Wan2.1:ComfyUI 文生视频与图生视频工作流
运行 1.3B 文生视频模型与 14B 图生视频模型,包含模型文件安装和两者的原生 ComfyUI 工作流。
Wan2.1 Video 系列为阿里巴巴于 2025年2月开源的视频生成模型,其开源协议为 Apache 2.0。 该系列提供两个版本:
- 14B(140亿参数)
- 1.3B(13亿参数) 覆盖文生视频(T2V)、图生视频(I2V)等多项任务。 该模型不仅在性能上超越现有开源模型,更重要的是其轻量级版本仅需 8GB 显存即可运行,大大降低了使用门槛。
<video controls> <source src="https://github.com/user-attachments/assets/4aca6063-60bf-4953-bfb7-e265053f49ef" type="video/mp4" /> </video>
[!TIP] > [tab] 本地用户 > > 请确保你的 ComfyUI 已经更新。 > > ComfyUI 下载 > ComfyUI 更新教程 > > 本指南里的工作流可以在工作流模板中找到。如果找不到,可能是 ComfyUI 没有更新。 > > 如果加载工作流时有节点缺失,可能原因有: > > 1. 你用的不是最新版(每夜版)。 > 2. 启动时有些节点导入失败。 > [tab] 云端用户 > > * Cloud 会在 ComfyUI 稳定版本发布后更新。 > > 所以,如果你发现本文档中有任何核心节点缺失,可能是因为新核心节点尚未在最新稳定版中发布。请等待下一个稳定版发布。
Wan2.1 ComfyUI 原生(native)工作流示例
[!TIP] 开始示例之前,请先将 ComfyUI 更新到最新版本,以确保你拥有原生的 Wan Video 支持。
模型安装
本指南中提到的所有模型都可以在这里找到。以下是本指南中的示例所需的常见模型,你可以提前下载:
从文本编码器中选择一个版本下载:
[card] umt5\_xxl\_fp16.safetensors FP16 精度文本编码器。放置于 ComfyUI/models/text_encoders/
[card] umt5\_xxl\_fp8\_e4m3fn\_scaled.safetensors FP8 缩放文本编码器。放置于 ComfyUI/models/text_encoders/
VAE
[card] wan\_2.1\_vae.safetensors Wan2.1 VAE 模型。放置于 ComfyUI/models/vae/
CLIP Vision
[card] clip\_vision\_h.safetensors 用于图像条件的 CLIP Vision 模型。放置于 ComfyUI/models/clip_vision/
文件保存位置:
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── ... (download per workflow below)
│   ├── text_encoders/
│   │   └── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│   ├── vae/
│   │   └── wan_2.1_vae.safetensors
│   └── clip_vision/
│       └── clip_vision_h.safetensors
[!NOTE] 对于 diffusion 模型,本指南将使用 fp16 精度模型,因为我们发现它们比 bf16 版本表现更好。如果你需要其他精度的版本,请访问这里下载。
Wan2.1 文生视频工作流 (1.3B)
Wan 2.1 文生视频
使用 Wan 2.1 根据文本提示生成视频。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索 "Wan 2.1 Text to Video"
模型下载
[card] wan2.1\_t2v\_1.3B\_fp16.safetensors Wan2.1 文生视频扩散模型。放置于 ComfyUI/models/diffusion_models/
如果你需要其他 t2v 精度版本,请前往这里下载。
运行步骤

- 确保
Load Diffusion Model节点已加载wan2.1_t2v_1.3B_fp16.safetensors模型 - 确保
Load CLIP节点已加载umt5_xxl_fp8_e4m3fn_scaled.safetensors模型 - 确保
Load VAE节点已加载wan_2.1_vae.safetensors模型 - (可选)如有需要,你可以在
EmptyHunyuanLatentVideo节点中修改视频尺寸 - (可选)如果你需要修改提示词(正向和负向),请在编号
5的CLIP Text Encoder节点中进行修改 - 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter执行视频生成
Wan2.1 图生视频工作流 (14B)
由于 Wan Video 将 480P 和 720P 模型分开,本指南需要为两种分辨率都提供示例。除了使用不同的模型外,它们的参数也略有不同。
480P 版本
Wan 2.1 图生视频
使用 Wan 2.1 根据图像生成视频。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索 "Wan 2.1 Image to Video"
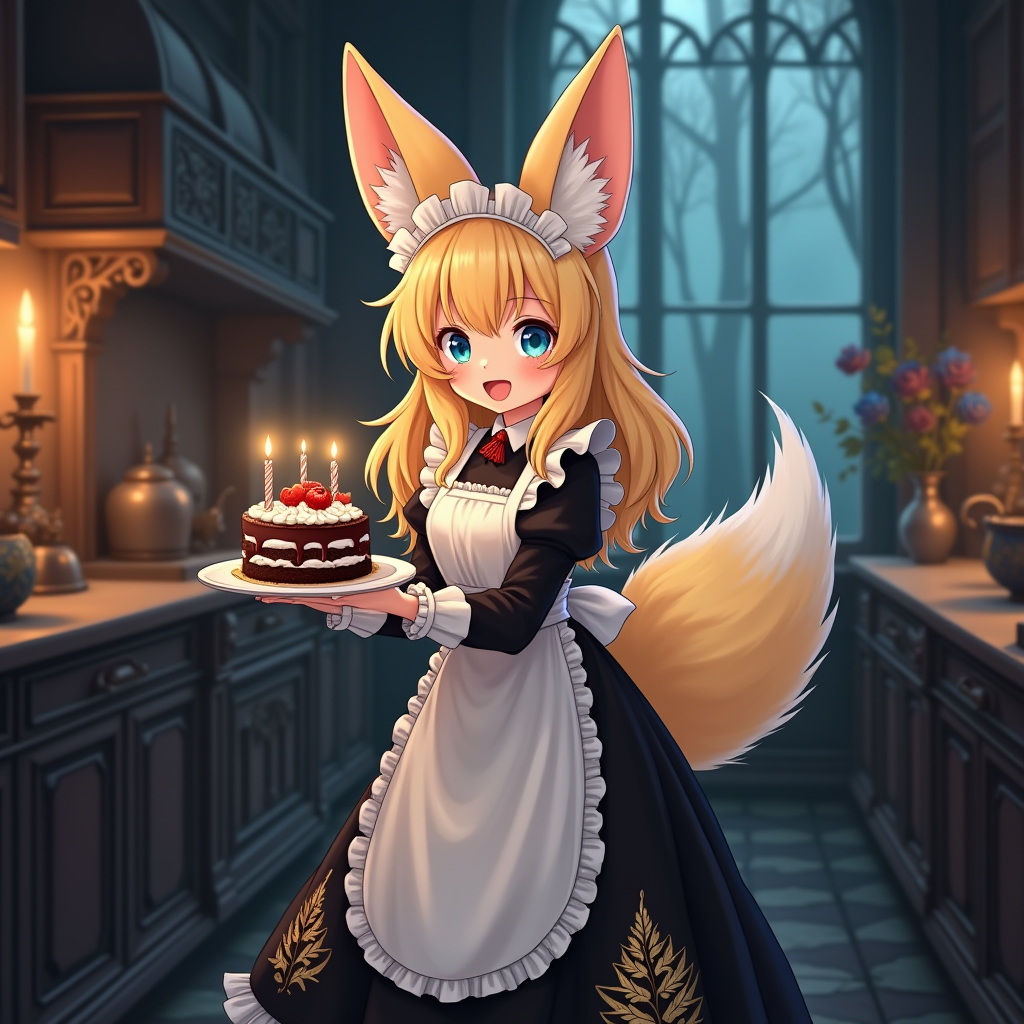
输入素材
将此文件上传到对应的 LoadImage 节点:
[card] image\_to\_video\_wan\_start\_image.pngLoadImage节点 52 ·image_to_video_wan_start_image.png
模型下载
[card] wan2.1\_i2v\_480p\_14B\_fp16.safetensors Wan2.1 I2V 480P 扩散模型。放置于 ComfyUI/models/diffusion_models/
运行步骤

- 确保
Load Diffusion Model节点已加载wan2.1_i2v_480p_14B_fp16.safetensors模型 - 确保
Load CLIP节点已加载umt5_xxl_fp8_e4m3fn_scaled.safetensors模型 - 确保
Load VAE节点已加载wan_2.1_vae.safetensors模型 - 确保
Load CLIP Vision节点已加载clip_vision_h.safetensors模型 - 在
Load Image节点中上传提供的输入图像 - (可选)在
CLIP Text Encoder节点中输入你想要生成的视频描述内容 - (可选)如有需要,你可以在
WanImageToVideo节点中修改视频尺寸 - 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter执行视频生成
720P 版本
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载工作流图片并将其拖入 ComfyUI 即可加载工作流
[card] 输入图像 下载默认输入图像,或使用你自己的图像。
模型下载
[card] wan2.1\_i2v\_720p\_14B\_fp16.safetensors Wan2.1 I2V 720P 扩散模型。放置于 ComfyUI/models/diffusion_models/
运行步骤

- 确保
Load Diffusion Model节点已加载wan2.1_i2v_720p_14B_fp16.safetensors模型 - 确保
Load CLIP节点已加载umt5_xxl_fp8_e4m3fn_scaled.safetensors模型 - 确保
Load VAE节点已加载wan_2.1_vae.safetensors模型 - 确保
Load CLIP Vision节点已加载clip_vision_h.safetensors模型 - 在
Load Image节点中上传提供的输入图像 - (可选)在
CLIP Text Encoder节点中输入你想要生成的视频描述内容 - (可选)如有需要,你可以在
WanImageToVideo节点中修改视频尺寸 - 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter执行视频生成