
Wan2.2 视频生成ComfyUI 官方原生工作流示例
在 ComfyUI 中运行 Wan2.2 视频工作流:5B 混合 TI2V 模型,以及 14B 文生视频、图生视频和首尾帧示例,附下载链接。
Wan2.2 视频生成ComfyUI 官方原生工作流示例
在 ComfyUI 中运行 Wan2.2 视频工作流:5B 混合 TI2V 模型,以及 14B 文生视频、图生视频和首尾帧示例,附下载链接。
ComfyUI Selection Toolbox New Features
通义万相 2.2(Wan 2.2)是阿里云推出的新一代多模态生成模型。该模型采用创新的 MoE(Mixture of Experts)架构,由高噪专家模型和低噪专家模型组成,能够根据去噪时间步进行专家模型划分,从而生成更高质量的视频内容。
Wan 2.2 具备三大核心特性:影视级美学控制,深度融合专业电影工业的美学标准,支持光影、色彩、构图等多维度视觉控制;大规模复杂运动,轻松还原各类复杂运动并强化运动的流畅度和可控性;精准语义遵循,在复杂场景和多对象生成方面表现卓越,更好还原用户的创意意图。 模型支持文生视频、图生视频等多种生成模式,适用于内容创作、艺术创作、教育培训等多种应用场景。
模型亮点
- 影视级美学控制:专业镜头语言,支持光影、色彩、构图等多维度视觉控制
- 大规模复杂运动:流畅还原各类复杂运动,强化运动可控性和自然度
- 精准语义遵循:复杂场景理解,多对象生成,更好还原创意意图
- 高效压缩技术:5B版本高压缩比VAE,显存优化,支持混合训练
Wan2.2 开源模型版本
Wan2.2 系列模型基于 Apache2.0 开源协议,支持商业使用。Apache2.0 许可证允许您自由使用、修改和分发这些模型,包括商业用途,只需保留原始版权声明和许可证文本。
| 模型类型 | 模型名称 | 参数量 | 主要功能 | 模型仓库 |
|---|---|---|---|---|
| 混合模型 | Wan2.2-TI2V-5B | 5B | 支持文本生成视频和图像生成视频的混合版本,单一模型满足两大核心任务需求 | 🤗 Wan2.2-TI2V-5B |
| 图生视频 | Wan2.2-I2V-A14B | 14B | 将静态图像转换为动态视频,保持内容一致性和流畅的动态过程 | 🤗 Wan2.2-I2V-A14B |
| 文生视频 | Wan2.2-T2V-A14B | 14B | 从文本描述生成高质量视频,具备影视级美学控制和精准语义遵循 | 🤗 Wan2.2-T2V-A14B |
ComfyOrg Wan2.2 直播回放
对于 ComfyUI Wan2.2 的使用,我们有进行了直播,你可以查看这些回放了解如何使用
本篇教程将使用 🤗 Comfy-Org/Wan\_2.2\_ComfyUI\_Repackaged的版本进行
[!TIP] > [tab] 本地用户 > > 请确保你的 ComfyUI 已经更新。 > > ComfyUI 下载 > ComfyUI 更新教程 > > 本指南里的工作流可以在工作流模板中找到。如果找不到,可能是 ComfyUI 没有更新。 > > 如果加载工作流时有节点缺失,可能原因有: > > 1. 你用的不是最新版(每夜版)。 > 2. 启动时有些节点导入失败。 > [tab] 云端用户 > > * Cloud 会在 ComfyUI 稳定版本发布后更新。 > > 所以,如果你发现本文档中有任何核心节点缺失,可能是因为新核心节点尚未在最新稳定版中发布。请等待下一个稳定版发布。

Wan2.2 TI2V 5B 混合版本工作流示例
[!TIP] 配合 ComfyUI 原生 offloading 功能,Wan2.2 5B 版本应能很好地适配 8GB 显存。
Wan 2.2 5B 视频生成
以 5B 参数实现快速的文生视频与图生视频生成。专为快速原型制作和创意探索而优化。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索“Wan2.2 5B”
2. 手动下载模型
所有提及的模型均可在 Comfy-Org/Wan\_2.2\_ComfyUI\_Repackaged 中找到。
Diffusion 模型
[card] wan2.2\_ti2v\_5B\_fp16.safetensors 5B 混合 diffusion 模型。放置于 ComfyUI/models/diffusion_models/
VAE
[card] wan2.2\_vae.safetensors Wan2.2 VAE。放置于 ComfyUI/models/vae/
文本编码器
[card] umt5\_xxl\_fp8\_e4m3fn\_scaled.safetensors FP8 文本编码器。放置于 ComfyUI/models/text_encoders/
ComfyUI/
├───📂 models/
│   ├───📂 diffusion_models/
│   │   └───wan2.2_ti2v_5B_fp16.safetensors
│   ├───📂 text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│   └───📂 vae/
│       └── wan2.2_vae.safetensors
3. 按步骤操作

- 确保
Load Diffusion Model节点加载了wan2.2_ti2v_5B_fp16.safetensors模型。 - 确保
Load CLIP节点加载了umt5_xxl_fp8_e4m3fn_scaled.safetensors模型。 - 确保
Load VAE节点加载了wan2.2_vae.safetensors模型。 - (可选)如果需要进行图生视频生成,可以使用快捷键 Ctrl+B 启用
Load image节点来上传图片。 - (可选)在
Wan22ImageToVideoLatent节点中,可以调整尺寸设置和视频总帧数(length)。 - (可选)如果需要修改提示词(正向和负面),请在步骤 5 的
CLIP Text Encoder节点中进行修改。 - 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter来执行视频生成。
Wan2.2 14B T2V 文生视频工作流示例
Wan 2.2 14B 文生视频
使用 Wan 2.2 从文本提示生成高质量视频,具备电影级美学控制与动态运动生成能力。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索“Wan2.2 14B T2V”
2. 手动下载模型
上述所有模型都可以在 Comfy-Org/Wan\_2.2\_ComfyUI\_Repackaged 中找到。
Diffusion 模型
[card] wan2.2\_t2v\_high\_noise\_14B\_fp8\_scaled.safetensors 高噪波 Diffusion 模型。放置到 ComfyUI/models/diffusion_models/
[card] wan2.2\_t2v\_low\_noise\_14B\_fp8\_scaled.safetensors 低噪波 Diffusion 模型。放置到 ComfyUI/models/diffusion_models/
VAE
[card] wan\_2.1\_vae.safetensors Wan2.1 VAE(与 Wan2.2 兼容)。放置到 ComfyUI/models/vae/
文本编码器
[card] umt5\_xxl\_fp8\_e4m3fn\_scaled.safetensors FP8 文本编码器。放置到 ComfyUI/models/text_encoders/
ComfyUI/
├───📂 models/
│   ├───📂 diffusion_models/
│   │   ├─── wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors
│   │   └─── wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors
│   ├───📂 text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│   └───📂 vae/
│       └── wan_2.1_vae.safetensors
3. 按步骤完成工作流

- 确保第一个
Load Diffusion Model节点加载了wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors模型。 - 确保第二个
Load Diffusion Model节点加载了wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors模型。 - 确保
Load CLIP节点加载了umt5_xxl_fp8_e4m3fn_scaled.safetensors模型。 - 确保
Load VAE节点加载了wan_2.1_vae.safetensors模型。 - (可选)在
EmptyHunyuanLatentVideo节点中,你可以调整尺寸设置和视频总帧数(length)。 - (可选)如果你需要修改提示词(正向和负面),请在步骤 5 的
CLIP Text Encoder节点中进行修改。 - 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter(回车)来执行视频生成。
Wan2.2 14B I2V 图生视频工作流示例
1. 工作流文件
请更新你的 ComfyUI 到最新版本,并通过菜单 工作流 -> 浏览模板 -> 视频 找到 “Wan2.2 14B I2V” 以加载工作流
或者更新你的 ComfyUI 到最新版本后,下载下面的工作流并拖入 ComfyUI 以加载工作流
<video controls src="https://raw.githubusercontent.com/Comfy-Org/example_workflows/refs/heads/main/video/wan/2.2/wan_2_2_14B_i2v.mp4" />
你可以使用下面的图片作为输入 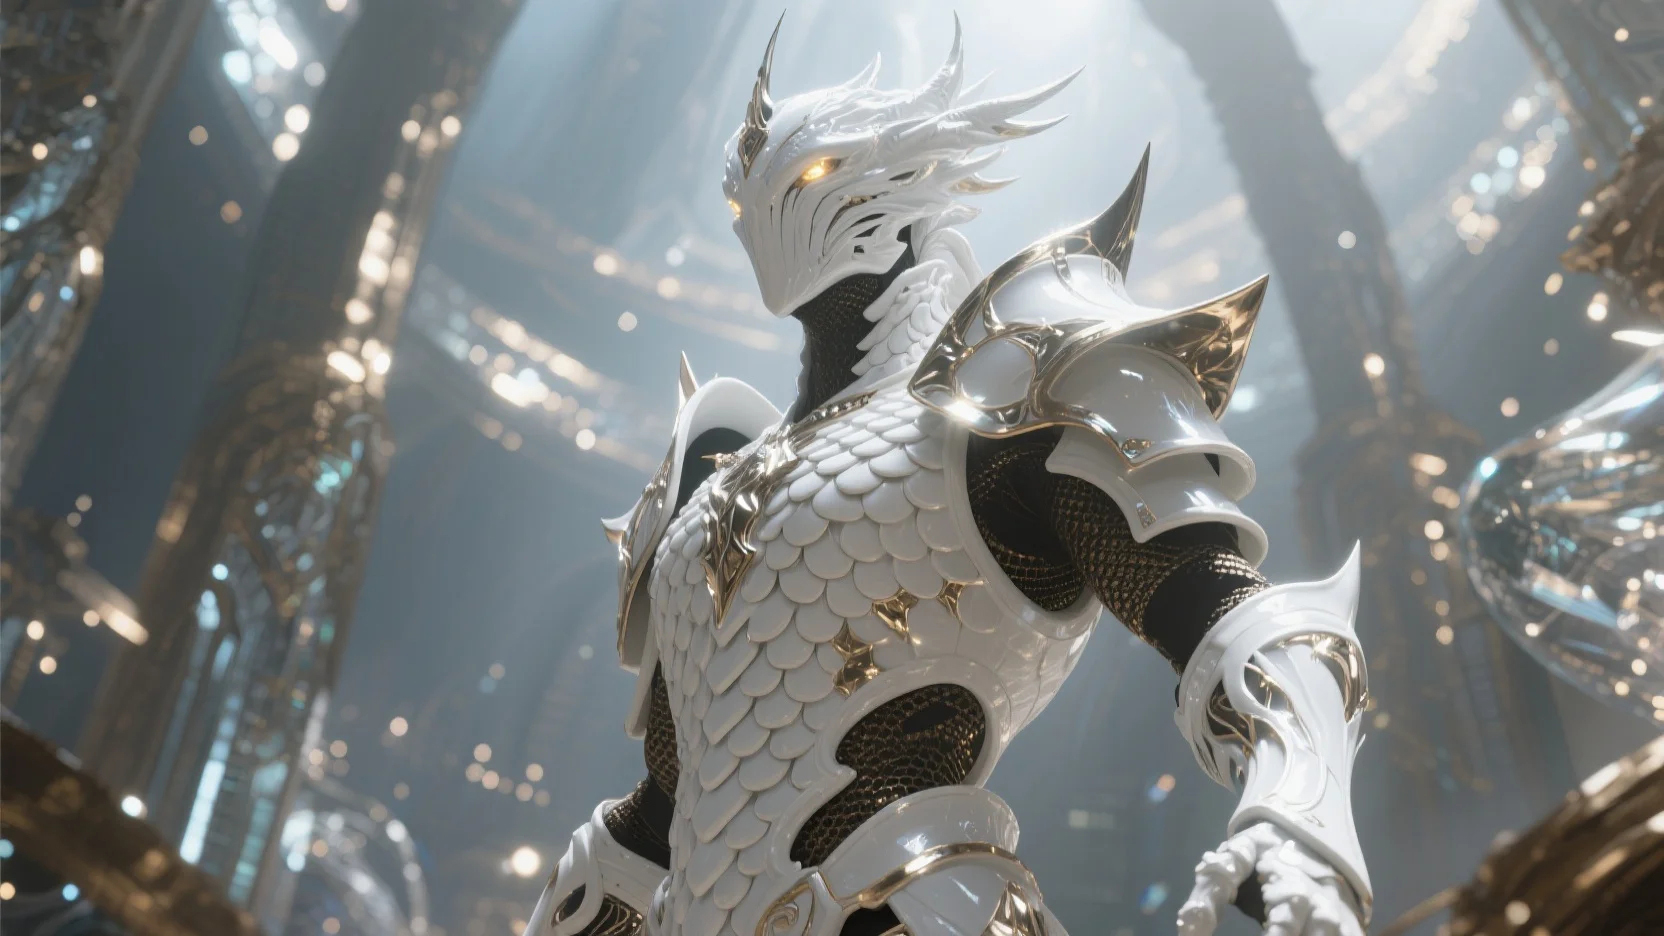
2. 手动下载模型
Diffusion Model
VAE
Text Encoder
ComfyUI/
├───📂 models/
│   ├───📂 diffusion_models/
│   │   ├─── wan2.2_i2v_low_noise_14B_fp16.safetensors
│   │   └─── wan2.2_i2v_high_noise_14B_fp16.safetensors
│   ├───📂 text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│   └───📂 vae/
│       └── wan_2.1_vae.safetensors
3. 按步骤完成工作流

- 确保第一个
Load Diffusion Model节点加载了wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors模型 - 确保第二个
Load Diffusion Model节点加载了wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors模型 - 确保
Load CLIP节点加载了umt5_xxl_fp8_e4m3fn_scaled.safetensors模型 - 确保
Load VAE节点加载了wan_2.1_vae.safetensors模型 - 在
Load Image节点上传作为起始帧的图像 - 如果你需要修改提示词(正向及负向)请在序号
6的CLIP Text Encoder节点中进行修改 - 可选)在
EmptyHunyuanLatentVideo你可以进行尺寸的设置调整,和视频总帧数length调整 - 点击
Run按钮,或者使用快捷键Ctrl(cmd) + Enter(回车)来执行视频生成
Wan2.2 14B FLF2V 工作流示例
首尾帧工作流使用的模型位置与 I2V 部分相同。
Wan 2.2 14B 首尾帧转视频
通过定义起始帧和结束帧,生成平滑的视频过渡。
[card] 在 Comfy Cloud 上运行 在 Comfy Cloud 中打开
[card] 下载工作流 下载 JSON,或在模板库中搜索 "Wan2.2 14B FLF2V"
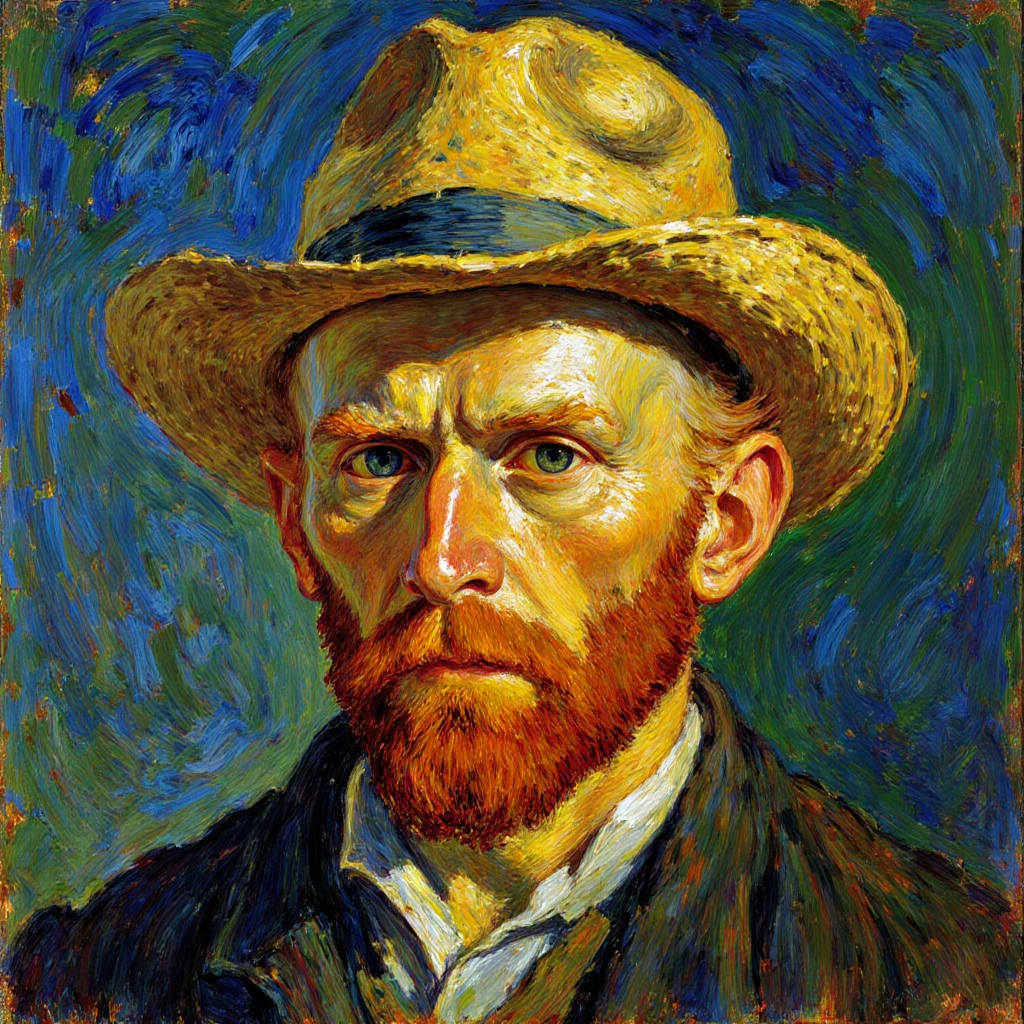
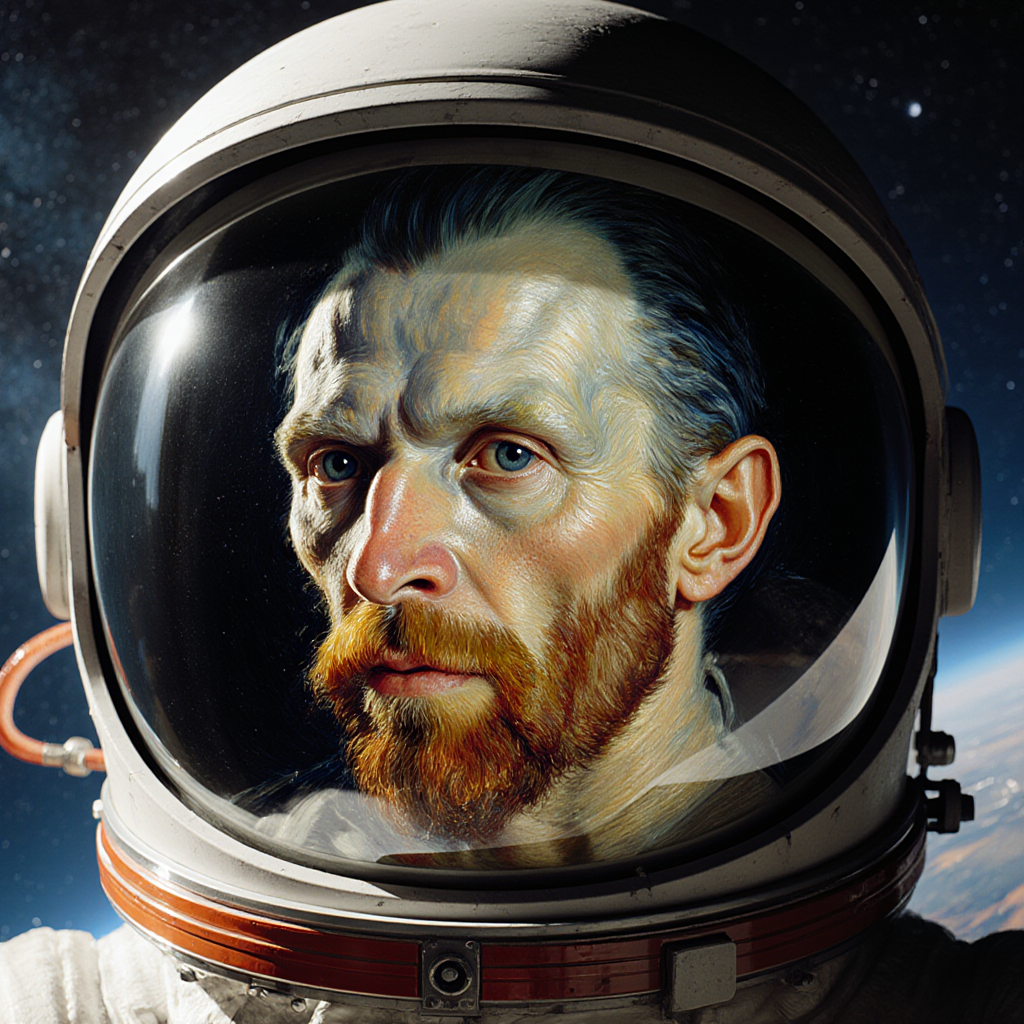
输入素材
将这些文件上传到对应的 LoadImage 节点:
[card] video\_wan2\_2\_14B\_flf2v\_start\_image.pngLoadImage节点 62 ·video_wan2_2_14B_flf2v_start_image.png
[card] video\_wan2\_2\_14B\_flf2v\_end\_image.pngLoadImage节点 68 ·video_wan2_2_14B_flf2v_end_image.png
2. 按步骤操作

- 在第一个
Load Image节点中上传要用作起始帧的图像。 - 在第二个
Load Image节点中上传要用作结束帧的图像。 - 调整
WanFirstLastFrameToVideo节点中的尺寸设置。 - 默认设置相对较小的尺寸,以防低显存用户消耗过多资源。
- 如果显存充足,可以尝试 720P 左右的分辨率。
- 根据你的首尾帧编写合适的提示词。
- 点击
Run按钮,或使用快捷键Ctrl(cmd) + Enter执行视频生成。
社区资源
GGUF 版本
自定义节点 City96/ComfyUI-GGUF
WanVideoWrapper
Wan2.2 models
Wan2.1 models
Lightx2v 4steps LoRA